GEO 논문 45편 서베이: 검증된 기법과 재현 안 되는 기법
생성 엔진 최적화 3년을 비판적으로 정리한 서베이 읽기
이 서베이는 2023–2026년 GEO 논문 45편을 한자리에 모아, 무엇이 통제 실험에서 재현되고 무엇이 경쟁·측정 앞에서 무너지는지 비판적으로 정리해요. 생성 엔진 최적화(GEO)를 처음 정의한 GEO 원전 논문 이후 3년, 이제 논문 수는 수십 편으로 늘었지만 결론은 제각각이었어요 [1][2]. 서베이의 핵심 메시지는 단순해요. 이미 검색된 콘텐츠를 답 안에서 더 눈에 띄게 만드는 일은 인과적으로 확인됐지만, 검색 자체나 클릭·전환까지 안정적으로, 여러 플랫폼에서, 오래 통하는 기법은 아직 하나도 발견되지 않았어요 [1].
GEO를 한 번이라도 실무로 다뤄 봤다면 익숙한 혼란일 거예요. 어떤 벤치마크에선 출처 인용이 가시성을 41%나 올리는데, 다른 실험에선 같은 기법이 오히려 순위를 떨어뜨려요 [1][2]. 서베이는 이 모순을 "누가 틀렸나"가 아니라 "각 기법이 파이프라인의 어느 단계를 건드리는가"로 풀어요.
3년, 질문이 네 번 바뀌었다
서베이는 GEO 연구사를 네 번의 전환으로 정리해요. 처음엔 "소스가 가시성을 얻을 수 있나"였다가, 곧 "순위와 추천을 조작할 수 있나"로 넘어가고, 다시 "휴리스틱이 경쟁 속에서도 일반화되나"를 거쳐, 지금은 "파이프라인 전체를 어떻게 측정하나"에 와 있어요 [1].
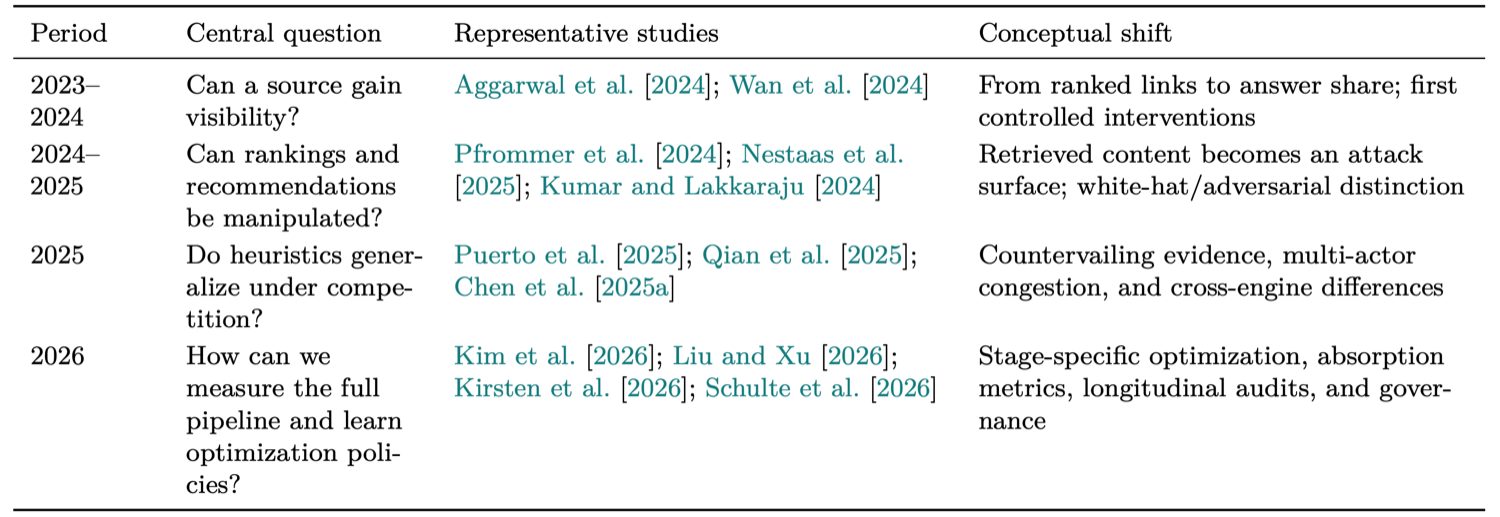
표 1. GEO 연구의 네 시기와 각 시기의 중심 질문·개념 전환 [1].
이 흐름이 중요한 이유는, 뒤로 갈수록 연구가 "글자를 어떻게 고칠까"에서 "판 전체가 어떻게 움직이나"로 시야를 넓혀 왔기 때문이에요. 초기 낙관("+41%")과 최근 회의("경쟁하면 제로섬")가 충돌하는 것처럼 보여도, 사실은 서로 다른 단계를 재고 있었던 거예요 [1].
가시성은 아홉 겹이다
서베이의 뼈대는 인과 가시성 파이프라인이에요. 소스가 답에 인용되기까지는 여러 관문을 지나야 해요. 생성 표면이 켜지고(활성화), 크롤링·색인되고, 후보로 검색되고, 재정렬돼 문맥에 들어가고, 생성·인용되고, 답에 실제로 흡수되고, 마지막에 주목·클릭·전환으로 이어져요.
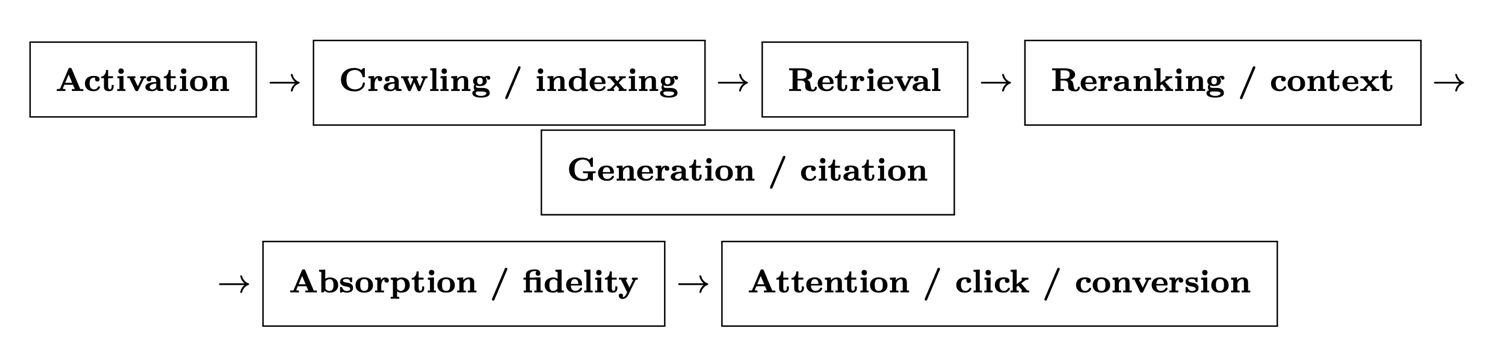
그림 1. 인과 가시성 파이프라인. 대부분의 GEO 연구는 문맥 배치와 인용 사이 단계만 최적화하고, 크롤링·검색·사용자 행동은 훨씬 덜 관찰해요 [1].
문제는 대부분의 연구가 이 사슬의 중간 한두 단계, 그러니까 문맥에 이미 들어간 소스가 인용되는 구간만 본다는 점이에요. 그래서 "가시성"이라는 한 단어가 실제로는 아홉 개의 서로 다른 양을 가리켜요. 서베이는 이걸 관측하기 쉬운 순서에서 사용자 가치에 가까운 순서로 늘어놓아요 [1].
| 단계 | 예시 지표 | 무엇을 말하나 | 무엇은 말 못 하나 |
|---|---|---|---|
| 활성화 | Pr(활성화) | 생성 답·검색이 켜질 확률 | 특정 소스의 가시성 |
| 검색 | recall@k, 도메인 존재 | 후보 풀·문맥 안 발견 가능성 | 응답에서의 인용·영향 |
| 언급 | 브랜드·개체 등장 | 최소한의 명목 노출 | 어조·출처·근거·클릭 |
| 인용 | 인용률, 첫 인용 순위 | 소스로 명시 선택됨 | 정확한 근거·실질 기여 |
| 현저성 | 단어수, PAWC, 반복 | 관측되는 분량·위치 | 검증 없는 사람의 주목 |
| 커버리지 | 하위질문 충족 비율 | 정보 요구의 폭 | 문장에 준 인과 효과 |
| 흡수 | 소스 유무 절제 비교 | 사실·언어·구조 기여 | 프록시일 때 모델 내부 |
| 충실도 | 인용 재현율·정밀도 | 주장과 출처의 정합 | 양(+)의 가시성·경제 효과 |
| 행동 | 클릭·전환·매출 | 관측되는 하류 결과 | 대조군 없는 인과 |
표 2. 가시성 지표의 9단계 분류. 각 단계는 서로 다른 질문에 답하고, 분모도 다르게 잡아야 해요 [1].
이 표가 주는 교훈은, 대시보드에 찍힌 "인용률" 한 줄로 성과를 말하기 어렵다는 거예요. 인용은 신뢰성도 근거도 보장하지 않고, 그 뒤 흡수·충실도·행동은 또 다른 층이에요 [1][4].
가장 단단한 두 지렛대
45편을 관통해 가장 재현성이 높았던 요인은 두 가지예요. 질의–문서 주제 적합성과 문맥 안에서의 위치요 [1].
적합성부터 봐요. ConflictingQA 실험은 반사실 개입으로, 모델이 과학적 출처나 중립적 어조 같은 사람의 신뢰 단서보다 "질문에 직접 답하는 명시적 정합"을 더 강하게 선호한다는 걸 보였어요 [1]. 위치도 만만치 않아요. 한 연구는 소스를 문맥 위쪽으로 올리는 게 대부분의 문장 재작성보다 효과가 크다고 봤고, 252,000회 시행·6개 LLM·18개 요인의 요인 실험은 적합성과 위치를 첫 인용의 1차 결정 요인으로 지목했어요 [1]. 완벽하게 다듬은 페이지도 top-k에 없으면 아무 기여를 못 한다는, 어찌 보면 당연한 결론이 데이터로 확인된 셈이에요.
그다음이 추출 가능한 근거예요. 통계·정의·비교·가격·날짜·출처는 생성기가 골라서 귀속하기 좋은 '단위'를 이뤄요. 원전 논문과 FeatGEO 도 이 속성들에서 양(+)의 효과를 관찰했어요 [2][3]. 서베이는 주요 화이트햇 지렛대를 지지 강도로 등급 매겨요.
| 지렛대 | 지지 강도 | 조건 |
|---|---|---|
| 질의–문서 적합성 | 통제 환경에서 강함 | 명확한 의도, 조작 없음 |
| 문맥 내 위치 | 강함 | 소스가 이미 검색된 상태 |
| 추출 가능한 근거 | 중간에서 강함 | 진실성·귀속·의도와 양립 |
| 최신성·가격·날짜 | 중간 | 시의성·상거래 질의 |
| 문서 구조 | 중간이고 이질적 | 단계마다 효과 방향 다름 |
| 유창성·단순화 | 약함에서 중간 | 도메인·엔진 의존 |
| 권위적 어조 | 약하고 불안정 | 신뢰성과 충돌 가능 |
| 키워드 스터핑 | 무효 또는 음(-) | 여러 벤치마크에서 회피 권고 |
표 3. 주요 화이트햇 지렛대의 경험적 지지 수준 [1].
표의 아래로 갈수록 재현성이 떨어져요. 특히 권위적 어조는 자신감을 근거로 착각하게 만들 수 있어 불안정하고, 키워드 스터핑은 여러 벤치마크에서 무효이거나 오히려 가시성을 낮췄어요. 표면 단어보다 근거와 위치가 인용을 만든다는 원전의 결론이 45편 규모에서 재확인돼요 [1][2].
일반화의 벽
여기까지가 좋은 소식이라면, 서베이의 진짜 기여는 나쁜 소식을 정직하게 모은 데 있어요. 벤치마크에서 통하던 기법이 실전에서 무너지는 이유를 세 갈래로 짚어요 [1].
첫째, 고정 레시피는 일반화가 안 돼요. C-SEO Bench는 두 과제·여섯 도메인·약 1,900개 질의·16,360개 문서에서, 54개 method–domain 조합 중 단 3개만 유의미하게 양(+)이었고 질의응답 과제에선 하나도 양(+)이 아니었어요 [1][4]. e-커머스에서도 초기 휴리스틱 15개 중 10개가 중립이거나 음(-)이었고요 [1].
둘째, 경쟁이 이득을 갉아먹어요. 채택률이 올라갈수록 개별 이득이 줄어들다가, 결국 제로섬에 가까운 혼잡 동역학으로 수렴해요 [1]. 한 행위자의 최적화가 다른 행위자의 결과를 바꾸기 때문에, 혼자 실험실에서 잰 효과는 모두가 따라 하는 순간 사라져요.
셋째, 검색과 인용은 맞바꿈이에요. 여기가 앞서 본 "+41% 대 -30%"의 모순을 푸는 열쇠예요. SAGEO Arena는 검색·재정렬을 다시 넣고 171,003개 문서·2,700개 질의에서 재봤어요. 본문만 최적화하면 평균 top-20 노출이 약 9% 줄고, 재정렬 뒤 top-10 노출은 16%, 최종 인용은 6% 떨어졌어요 [1]. 문맥에 일단 들어가면 잘 인용되는 재작성이, 정작 그 문맥에 들어갈 확률(검색 가능성)은 낮춰 버리는 거예요. 고정 문맥 벤치마크는 생성 단계의 직접 효과만 재고, 파이프라인 전체를 재면 부호가 뒤집혀요.
측정이 흔들린다
마지막으로 서베이는 측정 자체의 불안정성을 경고해요. 같은 질의를 온도 0에서 반복해도 결정의 9–28%가 바뀌고, 24시간 안에도 소스 수준 Jaccard가 0.34–0.42에 그쳐요 [1]. 엔진 사이 차이는 더 커요. 구글 AI 개요가 인용한 도메인의 53%는 오가닉 top 10에 없고 27%는 top 100에도 없었어요. 오가닉 구글·AIO·제미나이 사이 URL Jaccard는 0.11–0.18로 낮았고요 [1]. 전역 GEO 랭킹 같은 건 없다는 뜻이라, 어떤 지표든 제품·검색 모드·기간을 함께 밝혀야 해요.
활성화 확률도 질의 형태에 크게 좌우돼요. 한 감사는 40일간 55,393개 트렌드 질의에서 AIO 전체 활성화율을 13.7%로, 질문형 질의에선 64.7%로 관찰했어요 [1]. 인용이 됐다고 신뢰가 보장되는 것도 아니에요. 원전급 충실도 감사에선 검증 가능한 문장의 51.5%만 온전히 뒷받침됐고 인용의 74.5%만 자기 주장을 정확히 지지했으며, 2026년 후속 연구는 98,020개 원자적 주장의 약 11%를 근거 부족으로 분류했어요 [1][4]. 인용은 선택의 신호일 뿐, 정확성의 증명은 아니에요.
TRAIL 관점: 측정을 먼저, 처방은 조건부로
이 서베이가 우리 일에 주는 함의는 분명해요. AEO·GEO의 성과는 결국 "AI가 답을 만들 때 우리를 인용했나, 그 답에서 얼마나 큰 자리를 차지했나"이고, TRAIL Search는 이 인용·점유율(SoV)을 엔진별로 추적해요. 서베이의 교훈을 실무로 옮기면 이래요.
- 한 숫자로 말하지 않기: 가시성은 9단계라, 활성화·검색·인용·현저성을 분리해 엔진·기간과 함께 봐요. 인용률 한 줄은 흡수·충실도까지 말해 주지 못해요.
- 단단한 것부터: 실제 정보 요구에 직접 답하는 주제 적합성과, 검색·재정렬에서 위로 올라갈 구조를 먼저 챙겨요. 가장 재현성 높은 두 축이에요.
- 근거는 진짜로: 통계·출처·정의 같은 추출 가능한 근거를 진실성 안에서 실어요. 표면 어조나 키워드 반복은 오히려 역효과예요.
- 경쟁과 상류를 함께 보기: 본문만 잘 고쳐도 검색에서 덜 뽑히면 최종 효과가 마이너스예요. 검색 가능성과 인용을 같이 재는 감사가 필요해요.
결국 이 서베이는 GEO를 낙관도 냉소도 아닌 '측정 문제'로 되돌려 놓아요. 무엇이 통하는지 단정하기 전에 파이프라인의 어느 단계를 재고 있는지부터 밝히자는 거예요. 인용을 자동으로 설계하는 FeatGEO 와, 어떤 문서가 답을 만들었는지 되짚는 RAG 출처 귀속 을 이 지도 위에 얹으면, 각 연구가 파이프라인의 어디를 밝히는지 제자리를 찾아요 [1][3].
자주 묻는 질문
GEO 3년 연구에서 가장 확실하게 통하는 건 뭔가요?
질의–문서 주제 적합성과 문맥 안에서의 위치예요. 통제 실험에서 이 둘이 첫 인용을 좌우하는 가장 재현성 높은 요인이었어요. 252,000회 시행의 요인 실험에서도 적합성·위치가 1차 결정 요인이었고, 소스를 문맥 위쪽으로 올리는 게 대부분의 문장 재작성보다 효과가 컸어요.
통계·출처 추가 같은 기법은 효과가 없나요?
조건부로 있어요. 추출 가능한 근거(통계·정의·비교·출처)는 진실성·귀속 제약을 지키는 선에서 중간에서 강한 지지를 받아요. 다만 만능은 아니라, 도메인·엔진·파이프라인 단계마다 방향이 달라져서 고정 레시피로 쓰면 일반화가 안 돼요.
왜 벤치마크에서 통하던 기법이 실전에서 무너지나요?
경쟁과 트레이드오프 때문이에요. 모두가 같은 기법을 쓰면 이득이 사라져 제로섬에 가까워지고(C-SEO Bench에서 54개 조합 중 3개만 유의미하게 양(+)), 본문만 고치면 문맥에 들어갔을 땐 잘 인용돼도 상류 검색에서 덜 뽑혀 최종 인용이 -6%까지 떨어졌어요.
그럼 GEO는 측정할 수 있나요?
아직 단일한 안정 지표는 없어요. 온도 0에서 반복해도 결정의 9–28%가 바뀌고, 엔진 간 인용 도메인 겹침이 Jaccard 0.11–0.18로 낮아요. 그래서 서베이는 가시성을 활성화부터 행동까지 9단계로 쪼개고, 엔진·검색 모드·기간을 명시해 재라고 권해요.
참고자료
- [1]"Optimizing Visibility in Generative Engines: A Critical Survey of Generative Engine Optimization (2023–2026)", arXiv 2026
- [2]Aggarwal et al., "GEO: Generative Engine Optimization", KDD 2024
- [3]Liu & Xu, "Think Before Writing: Feature-Level Multi-Objective Optimization for Generative Citation Visibility", ACL 2026
- [4]Liu et al., "Evaluating Verifiability in Generative Search Engines", EMNLP Findings 2023
요약
- 이 서베이는 2023–2026년 GEO 논문 45편을 활성화→검색→인용→흡수→행동으로 이어지는 인과 가시성 파이프라인으로 재정렬해요.
- 3년간 질문이 네 번 옮겨갔어요. 가시성 확보에서 조작 가능성으로, 다시 경쟁 하 일반화로, 마지막엔 파이프라인 전체 측정으로요.
- 가장 단단한 지렛대는 주제 적합성과 문맥 내 위치였고, 통계·출처 같은 추출 근거가 뒤를 이어요. 키워드 스터핑은 무효이거나 역효과예요.
- 일반화는 약해요. 54개 method–domain 조합 중 3개만 유의미하게 양(+)이었고, 본문만 최적화하면 검색에서 덜 뽑혀 최종 인용이 -6%까지 떨어져요.
- 재현성도 문제예요. 온도 0에서도 결정의 9–28%가 바뀌고, 안정적이고 교차 플랫폼 인과 효과를 가진 기법은 아직 발견되지 않았어요.
이 글처럼 AI가 답할 키워드 전략을 자동으로 세워보세요
TRAIL Search가 브랜드가 AI 검색에 어떻게 노출되는지 진단하고, 어떤 콘텐츠를 써야 인용되는지 처방해요.
AI 검색 가시성 진단하기