FeatGEO: AI 인용을 만드는 건 키워드일까 구조일까, 피처 단위 GEO
글자를 고치는 대신 '피처'를 최적화하는 생성형 엔진 최적화
FeatGEO는 웹페이지를 구조·내용·언어 '피처'로 추상화한 뒤, AI 인용 가시성과 콘텐츠 품질을 동시에 최적화하고 그 설계대로 글을 다시 생성하는 생성형 엔진 최적화(GEO) 방법이에요. ACL 2026에 발표된 Think Before Writing 논문이 제안했고, 글자를 직접 고치던 기존 방식의 한계를 피처 단위 최적화로 넘어서요 [1]. GEO라는 문제 자체의 정의와 지표는 GEO 원전 논문에서 다뤘으니, 여기서는 그 위에 얹힌 최적화 방법을 파고들어요.
Perplexity·구글 AI 개요 같은 생성형 검색은 순위를 매기는 대신, 검색된 여러 페이지 중 일부만 골라 인용하며 답을 합성해요. 그래서 이제 노출은 순위가 아니라 인용 여부가 가시성을 정해요. "AI가 이 답을 만들 때 왜 다른 페이지 대신 우리를 인용할까"라는 질문에 답하는 게 GEO예요 [2].
글자만 고치면 왜 부족할까
기존 GEO는 대부분 토큰 단위였어요. 키워드를 끼워 넣거나 권위적인 문장을 덧붙이는 식으로 본문을 직접 편집했죠. 이 방식엔 두 가지 약점이 있어요 [1].
- 불안정성: 하나의 고정 질의에 맞춰 최적화하지만, 실제로 LLM은 같은 주제 아래 다양한 사용자 의도를 마주해요. 질의가 조금만 바뀌어도 효과가 흔들려요.
- 불투명성: 글자를 직접 만지면 '무엇을 말하는가'와 '어떻게 표현하는가'가 뒤엉켜서, 인용을 실제로 좌우하는 상위 속성이 가려져요.
그림 1. 토큰 단위 편집과 피처 단위 최적화의 차이.
FeatGEO의 발상은 여기서 출발해요. 글자를 바로 고치는 대신, 페이지를 해석 가능한 피처 벡터로 바꿔서 그 공간에서 최적화하고, 그 설계를 LLM이 자연스러운 문장으로 실현하게 해요. 논문 제목 그대로 "쓰기 전에 생각하기"예요.
FeatGEO: 페이지를 피처로 바꾸고 최적화한다
먼저 단일 질의 대신 주제(topic) 단위로 인용을 모델링해요. 주제 τ에 대해 LLM이 의미가 비슷한 질의 여러 개를 만들고, 각 질의의 인용 결과를 모아 문서별 인용 빈도를 계산해요. 자주 인용되는 페이지가 그 주제의 '대표 예시'가 돼요 [1].
각 페이지는 세 층위의 13개 피처로 표현돼요. 이 값들은 딱딱한 제약 대신 생성 가이드로 쓰이는 '부드러운 신호'예요 [1].
| 층위 | 피처 | 범위 | 뜻 |
|---|---|---|---|
| 구조 | has_intro_summary | 0–1 | 도입 요약 문단 유무 |
| 구조 | headings_level | 1–3 | 제목·소제목의 위계와 수 |
| 구조 | list_density | 0–3 | 불릿·번호 리스트 빈도 |
| 구조 | length_level | 1–3 | 글 길이(내용의 깊이·폭) |
| 내용 | statistics_level | 0–3 | 데이터·통계·수치 밀도 |
| 내용 | cite_sources_level | 0–3 | 권위 출처·기관·리포트 인용 빈도 |
| 내용 | quotation_level | 0–3 | 전문가·권위자 인용 빈도 |
| 내용 | unique_info_level | 0–3 | 차별적 정보의 풍부함 |
| 내용 | technical_terms_level | 0–3 | 전문 용어 밀도 |
| 언어 | authoritative_level | 0–3 | 단정적·권위적 어조 강도 |
| 언어 | easy_to_understand_level | 1–3 | 가독성·언어 단순성 |
| 언어 | fluency_level | 1–3 | 유창성·문장 간 논리 응집 |
| 언어 | keyword_focus_level | 1–3 | 핵심 키워드 집중·반복 |
표 1. FeatGEO가 쓰는 세 층위 13개 피처.
피처는 어떻게 실제 문장이 될까요. 최적화가 정한 피처 값이 시스템 프롬프트의 생성 지시문으로 번역돼요. 이산 피처(예: 유창성)는 낮음·중간·높음 세 단계 지시로, 연속 피처(예: 통계 밀도)는 목표 비율로 선형 매핑돼요. 덕분에 최적화는 저차원 피처 공간에서 깔끔하게 하고, 문장으로 옮기는 일은 LLM이 맡아 문체가 자연스럽게 유지돼요 [1].
이제 목표는 두 가지를 동시에 만족하는 피처 설정을 찾는 거예요. 가시성과 품질은 서로 경쟁하는 목표라, 하나의 최댓값보다 Pareto 최적의 관점에서 봐요.
품질 목표는 내용 품질과 매력도를 가중 결합해 재요. 계수 로 둘의 비중을 조절해요 [1][4].
이 문제는 미분이 안 되는 블랙박스라, 진화 알고리즘 NSGA-II로 풀어요 [3]. 경쟁 페이지에서 뽑은 피처로 후보 집단을 초기화하고, 세대마다 각 설정을 LLM으로 페이지로 실현한 뒤 주제 질의들에 대해 가시성·품질을 평가하고, 비지배 정렬로 집단을 갱신해요. 결과로 Pareto 곡선 위의 여러 설정이 나와요.
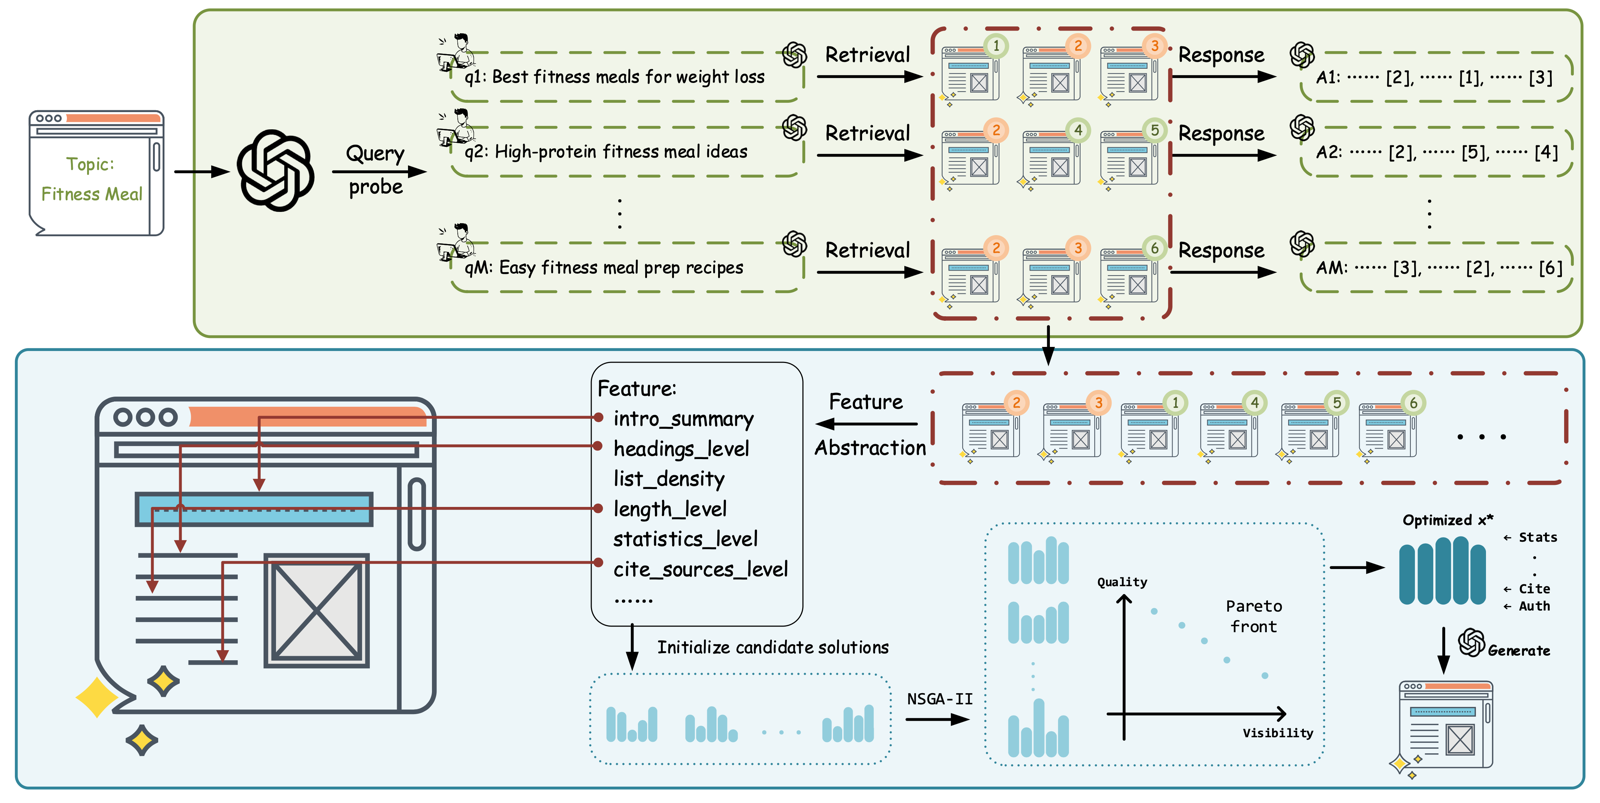
그림 2. FeatGEO 전체 파이프라인: 주제 질의 탐침 → 피처 추상화 → NSGA-II Pareto 탐색 → 생성.
무엇이 인용을 만드는가
어떤 피처가 인용을 만드는지는 피처 하나를 최솟값으로 고정했을 때 가시성이 얼마나 떨어지는지로 재요. 이 감소량이 그 피처의 기여도예요 [1].
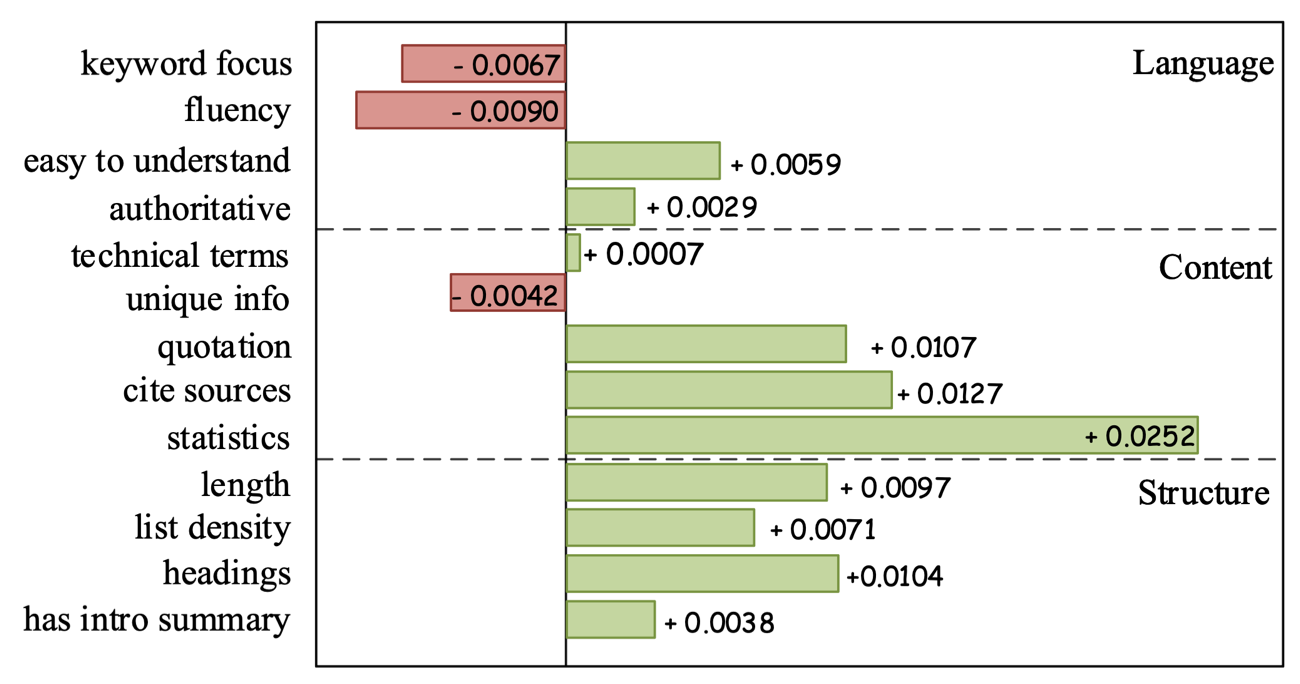
그림 3. 피처별 인용 가시성 기여도(내용 피처가 지배적).
내용(Content) 피처가 지배적이에요. 통계·수치 밀도가 가장 크게(+0.0252) 기여했고 권위 출처 인용(+0.0127), 전문가 인용(+0.0107)이 뒤따랐어요. 구조 피처(제목·길이·리스트)는 꾸준하지만 중간 정도였고요. 반대로 유창성(-0.0090)과 키워드 집중(-0.0067)은 가시성을 오히려 낮췄고, 고유 정보나 전문 용어는 영향이 미미했어요 [1]. 표면 단어를 다듬는 것보다 근거와 정보 구조가 인용을 부른다는 뜻이에요.
세 생성 엔진(GPT-4o-mini·Gemini-2.5-flash·Qwen-plus)에서 이 원리는 큰 폭의 개선으로 이어졌어요. 위치 보정 단어수 기준으로 기준선 대비 각각 약 37%·73%·96% 상대 개선하면서, 품질도 유지하거나 오히려 높였어요 [1].
| 방법 | 가시성 · GPT-4o-mini | 가시성 · Gemini | 가시성 · Qwen-plus |
|---|---|---|---|
| Baseline | 13.34 | 8.89 | 5.20 |
| 토큰 단위 최고(AutoGEO-instance) | 12.12 | 7.04 | 4.25 |
| FeatGEO | 18.31 | 15.35 | 10.17 |
표 2. 세 생성 엔진에서의 인용 가시성 비교(단위 %). 심판을 Gemini·Claude로 바꿔도 순위가 유지됐다 [1].
가시성과 품질은 맞바꾼다
가시성과 품질은 한쪽을 얻으면 다른 쪽을 조금 내주는 관계예요. 논문은 교육 도메인의 한 질의에서 Pareto 곡선의 양 끝 해를 비교해요. 해 A는 가시성 23.7%·품질 87.8%, 해 B는 가시성 8.4%·품질 92.7%로, 같은 주제인데 설계가 완전히 달라요 [1].
| 층위 | 피처 | 해 A (가시성 23.7%) | 해 B (품질 92.7%) |
|---|---|---|---|
| 내용 | 통계 밀도 | 1.62 | 2.18 |
| 내용 | 전문가 인용문 | 2.84 | 1.94 |
| 언어 | 유창성 | 2.17 | 1.58 |
| 언어 | 권위 어조 | 1.55 | 0.75 |
| 구조 | 리스트 밀도 | 1.26 | 2.01 |
표 3. 교육 도메인 Pareto 양 끝 해의 피처 대비.
가시성을 끌어올리는 설계와 품질을 끌어올리는 설계가 다르다는 게 핵심이에요. 해 A처럼 인용문·유창성·권위 어조가 높으면 인용이 잘 되고, 해 B처럼 리스트·구조가 촘촘하면 사람이 읽기 좋은 품질이 올라가요. 정답이 하나로 정해지지 않고, 목표에 맞춰 곡선 위 한 점을 고르는 문제예요.
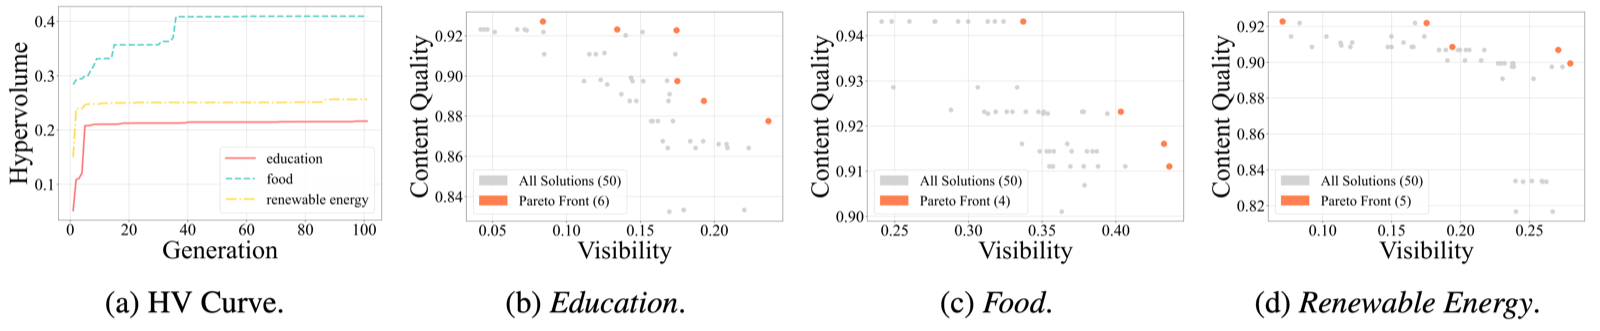
그림 4. 주제별 가시성·품질 Pareto 곡선과 하이퍼볼륨(HV) 수렴.
모델이 커져도 통한다
최적화한 피처 설정이 특정 모델에만 맞춰진 건 아닐까요. 논문은 페이지 생성 모델을 Qwen3-4B·8B·14B로 바꿔가며 확인했어요. FeatGEO는 모든 크기에서 기준선을 일관되게 앞섰고, 품질도 떨어지지 않았어요. 모델 크기에 따른 편차가 FeatGEO와 기준선의 격차보다 훨씬 작아서, 최적화된 피처가 모델에 무관한 원리를 담고 있다는 뜻이에요 [1].
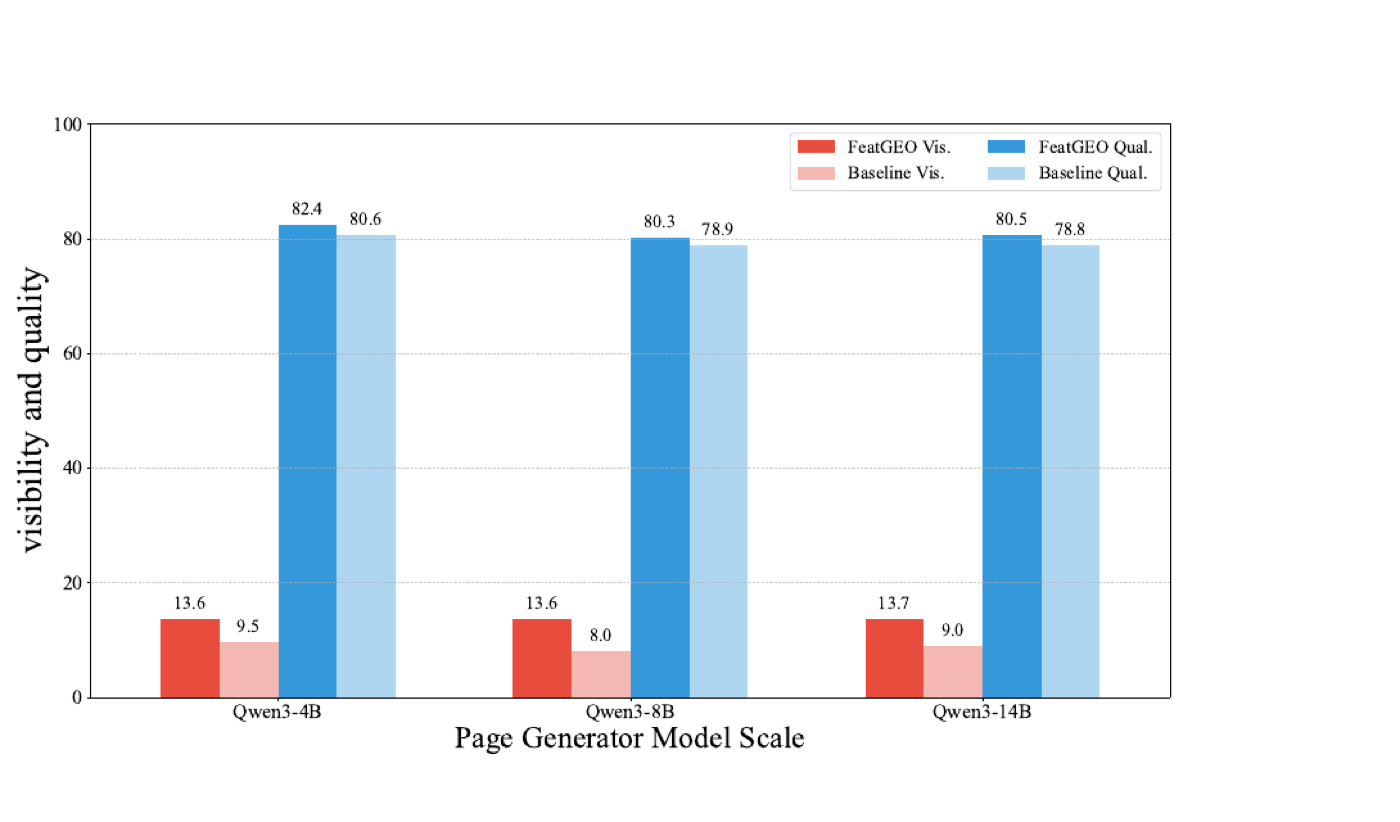
그림 5. 생성 모델 크기(4B·8B·14B)를 바꿔도 유지되는 FeatGEO 우위.
사람이 쓴 페이지에선 반대로 흐른다
흥미로운 반전도 있어요. 이미 잘 쓰인 LLM 생성 콘텐츠에서는 유창성·키워드 같은 토큰 단위 수정이 가시성을 떨어뜨렸는데, 사람이 쓴 덜 다듬어진 경쟁 페이지에서는 같은 기법이 평균 +0.99포인트 올렸어요 [1]. 구조가 비어 있는 페이지엔 표면 수정이 도움이 되지만, 이미 매끄러운 글엔 중복과 부자연스러움만 더한다는 거예요. FeatGEO는 글자를 국소적으로 고치지 않고 피처 설계로부터 페이지를 새로 합성하기 때문에 이 함정을 피해요.
이 방법의 한계
논문은 스스로 네 가지 한계를 밝혀요 [1].
- 고정된 후보군: 검색된 5개 페이지에 광고주 페이지가 이미 포함된 상태를 가정해요. 상류의 검색·랭킹으로 페이지가 뽑히는 과정은 다루지 않아요.
- 인용 파싱 의존: 적합도 신호가 LLM 생성 답변과 자동 인용 파싱에서 나와요. 실제 엔진마다 인용 형식이 달라 전이성이 열린 문제예요.
- LLM 심판: 품질을 LLM이 평가해서, 여러 번 평균을 내도 체계적 편향이나 환각이 섞일 수 있어요.
- 계산 비용: 진화 탐색이 페이지 생성·답변·평가 LLM 호출을 반복해요. 표본 효율이나 대리 모델은 향후 과제예요.
TRAIL 관점: 인용은 설계의 문제
이 연구가 던지는 질문은 우리가 매일 다루는 문제와 닿아 있어요. AEO·GEO에서도 결국 'AI가 이 답을 만들 때 어떤 소스에 기댔나'가 성과이고, TRAIL Search는 그 인용·점유율(SoV) 신호를 추적해요. 논문의 교훈을 실무 체크리스트로 옮기면 이래요.
- 근거를 촘촘히: 통계·수치와 권위 출처 인용, 전문가 인용문을 본문에 실어요. 기여도가 가장 큰 축이에요.
- 구조를 세워요: 도입 요약·명확한 제목 위계·적절한 길이로 뼈대를 잡아요. 꾸준한 이득을 줘요.
- 키워드 반복은 줄여요: 유창성만 억지로 높이거나 키워드를 도배하면 오히려 인용이 줄 수 있어요.
- 목표를 정해 고르기: 가시성과 품질은 맞바꿈이라, 지금 필요한 쪽으로 곡선 위 한 점을 선택해요.
결국 FeatGEO는 GEO를 '글자 고치기'에서 '설계 고르기'로 옮겨 놓았어요. 무엇을 담을지 피처로 정하고, 어떻게 쓸지는 생성 모델에 맡기면, AI 답변 속 우리 자리는 표면 기교보다 근거와 구조로 넓어져요. 어떤 문서가 답을 만들었는지 되짚는 RAG 출처 귀속 연구와 함께 보면, 측정과 설계가 한 쌍으로 맞물려요.
2026년 9월 업데이트
이 논문의 '내용 피처가 지배적'이라는 결론은 실무에서 그대로 쓸 수 있어요. 초안을 쓸 때 문장부터 쓰지 말고 어떤 근거를 담을지 먼저 고른 뒤, 브랜드가 실제로 가진 사실만 재료로 넣는 거예요. 통계·출처 피처가 인용에 크게 기여하지만, 지어낸 숫자로 채우면 의미가 없으니 출처 없는 수치는 넣지 않는 편이 나아요. 다만 본문 수사(통계·출처·인용문)의 효과는 구조나 권위보다 작고, 같은 기법을 여러 퍼블리셔가 동시에 쓰면 이득이 줄어든다는 반대 결과도 함께 있어요.
이 글과 이어지는 내용은 AI는 두 페이지 중 무엇을 인용할까? 경쟁 인용의 4대 게이트키퍼, 구조만 바꿔도 AI 인용이 오를까? 헤딩·문단 길이·문서 골격 실증, GEO-16 인용 신호 프레임워크: AI가 인용하는 페이지의 특징에서 볼 수 있어요.
자주 묻는 질문
FeatGEO가 기존 GEO와 뭐가 다른가요?
기존 GEO는 키워드 삽입·권위적 표현 추가처럼 글자를 직접 고쳐요. FeatGEO는 페이지를 구조·내용·언어 13개 피처로 추상화해 그 설계 공간에서 최적화한 뒤, 최적 설계대로 글을 다시 생성해요. 무엇을 바꿀지(피처)와 어떻게 쓸지(문장)를 분리해서 더 안정적이고 해석 가능해요.
피처는 어떻게 실제 문장이 되나요?
피처 값이 시스템 프롬프트의 생성 가이드로 번역돼요. 이산 피처(예: 유창성)는 낮음·중간·높음 세 단계 지시문으로, 연속 피처(예: 통계 밀도)는 목표 비율로 선형 매핑돼요. 그래서 최적화는 저차원 피처 공간에서 하고, 실현은 LLM이 자연스러운 문장으로 맡아요.
어떤 피처가 AI 인용에 가장 크게 기여하나요?
논문의 기여도 분석에서는 내용(Content) 피처가 가장 컸어요. 통계·수치 밀도(+0.0252)와 권위 출처 인용(+0.0127), 전문가 인용(+0.0107)이 가시성을 크게 올렸어요. 반대로 유창성이나 키워드 반복은 오히려 가시성을 낮추기도 했어요.
가시성과 품질은 같이 올릴 수 있나요?
둘은 서로 경쟁하는 목표라 하나의 정답보다 Pareto 절충 곡선으로 봐야 해요. 유창하고 권위적인 설정은 가시성을, 구조적이고 리스트가 많은 설정은 품질을 끌어올려요. FeatGEO는 세 엔진에서 가시성을 37–96% 상대 개선하면서 품질을 유지하거나 오히려 높였고, 이 효과는 생성 모델 크기가 바뀌어도 유지됐어요.
참고자료
- [1]Liu & Xu, "Think Before Writing: Feature-Level Multi-Objective Optimization for Generative Citation Visibility", ACL 2026
- [2]Aggarwal et al., "GEO: Generative Engine Optimization", KDD 2024
- [3]Deb et al., "A Fast and Elitist Multiobjective Genetic Algorithm: NSGA-II", IEEE TEC 2002
- [4]Liu et al., "G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment", EMNLP 2023
- [5]FeatGEO 구현 코드 (EvoNexusX/2026LiuFeatGEO)
요약
- FeatGEO는 웹페이지를 구조·내용·언어 13개 피처로 추상화해, AI 인용 가시성과 콘텐츠 품질을 함께 최적화하고 그 설계대로 글을 다시 생성하는 GEO 방법이에요.
- 핵심은 '무엇을 바꿀지(피처 최적화)'와 '어떻게 쓸지(LLM 생성)'를 분리하는 거예요. 쓰기 전에 생각하기죠.
- 가시성·품질은 경쟁 목표라 NSGA-II로 Pareto 최적해를 찾고, 세 엔진에서 가시성을 37–96% 올리면서 품질을 유지·개선했어요.
- 인용을 만드는 건 키워드 반복보다 통계·출처·인용 같은 내용 피처와 구조였고, 이 원리는 생성 모델 크기가 바뀌어도(4B–14B) 그대로 통했어요.
- 다만 이미 잘 쓰인 콘텐츠에선 토큰 단위 수정이 역효과라, 설계를 바꿔 다시 쓰는 접근이 더 안전해요.
이 글처럼 AI가 답할 키워드 전략을 자동으로 세워보세요
TRAIL Search가 브랜드가 AI 검색에 어떻게 노출되는지 진단하고, 어떤 콘텐츠를 써야 인용되는지 처방해요.
AI 검색 가시성 진단하기