AI는 두 페이지 중 무엇을 인용할까? 경쟁 인용의 4대 게이트키퍼
6개 LLM에 252,000번 물어 밝힌 경쟁적 인용의 4대 게이트키퍼
AI 답변 엔진이 두 후보 페이지 중 무엇을 인용하느냐는 주제 일치, 가격 명시, 최신 타임스탬프, 컨텍스트 안 앞자리라는 4개 게이트키퍼가 사실상 결정하고, 이 중 하나만 무너져도 나머지 콘텐츠 강점과 무관하게 인용 확률이 0에 가까워져요. Sprinklr 연구진이 6개 상용 LLM에 18개 콘텐츠 요인을 하나씩 붙여 252,000번 물은 통제 실험의 결론이에요 [1]. 두 후보만 답변 컨텍스트에 넣고 요인 하나만 다르게 바꿔, "비슷한 두 페이지가 붙었을 때 어느 쪽이 인용을 따내는가"를 요인별 승산비로 분리했어요.
이건 지금까지의 GEO 연구와 질문이 달라요. GEO 원전 논문은 고정된 검색 결과 안에서 한 페이지가 얼마나 인용에 반영되는지를 쟀지만 [2], 실제 AI 답변에서 가시성의 병목은 순위보다 인용 슬롯을 경쟁자와 겨뤄 따내는 데 있어요. 이 논문은 그 경쟁을 직접 재현했어요.
왜 '경쟁 인용'을 따로 재야 할까
전통적 SEO는 순위를 최적화하지만, RAG 기반 AI 답변 엔진은 검색된 후보 중 일부만 골라 인용해요. 그래서 가시성의 병목이 "얼마나 잘 검색되는가"에서 "인용 슬롯을 놓고 경쟁자를 이기는가"로 옮겨가요.
기존 연구에는 두 공백이 있었어요. 첫째, 단일 소스의 가시성 점수는 재도 두 후보가 직접 붙을 때의 상대 선호는 추정하지 않았어요 [2]. 둘째, 실서비스 로그는 콘텐츠 효과와 검색 순위, 제시 순서, 인터페이스 요소가 뒤섞여 있어 어떤 콘텐츠 요인이 인용을 유발했는지 분리할 수 없었어요. 이 논문은 두 후보만 주입한 통제된 테스트베드에서 요인 하나만 바꾸고, 브랜드를 익명화하고, 제시 순서를 서로 바꿔 실험해 이 두 문제를 동시에 풀어요.
두 후보만 두고, 요인 하나만 바꾼다
핵심 설계는 "요인 1개 격리"예요. 50개 B2C 제품 카테고리에서 카테고리당 2개씩 실제 리뷰 블로그 100개를 골라, GPT-4o로 브랜드와 발행처 이름을 가상 별칭으로 바꿨어요 [1]. 사전학습으로 이미 아는 브랜드를 선호하는 편향을 없애기 위해서예요. 그다음 사실과 가격, 스펙, 길이는 그대로 두고 딱 한 요인만 다른 두 변형을 만들어, 두 후보를 답변 컨텍스트에 나란히 넣고 어느 쪽을 인용하는지 봤어요.
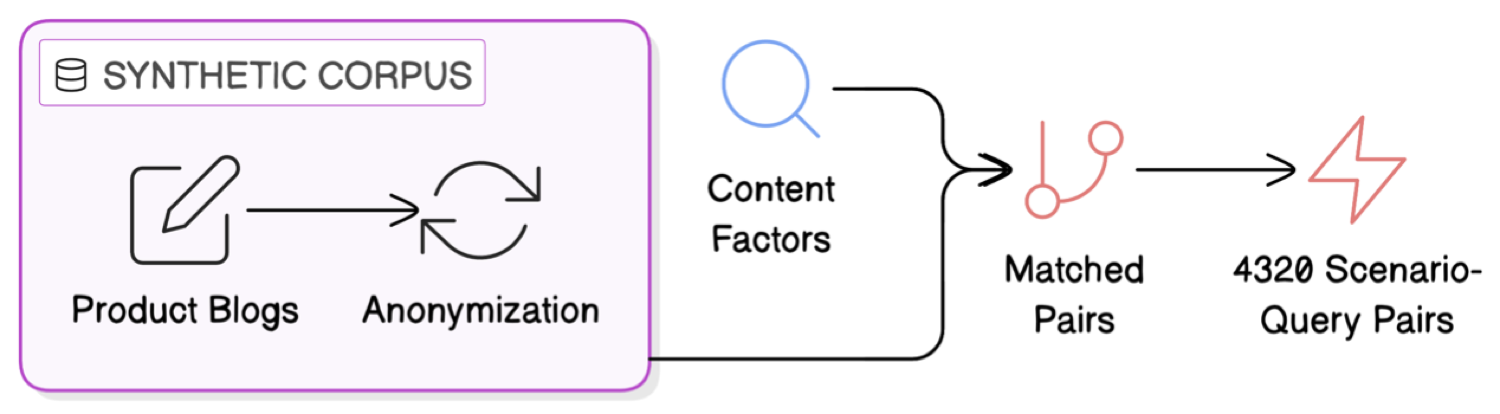
그림 1. 실제 제품 블로그를 모아 브랜드를 익명화한 합성 코퍼스에서, 콘텐츠 요인별 매칭 쌍을 만들어 4,320개 시나리오-질의 쌍까지 이어지는 파이프라인 [1].
측정 대상은 표와 같은 18개 요인이에요. 콘텐츠 적합성부터 완전성, 신뢰성, 가독성, 경쟁 포지셔닝, 최신성까지 6개 범주로 묶었어요 [1].
| 범주 | 대표 요인 |
|---|---|
| 콘텐츠 적합성 | 주제 불일치, 키워드 갭 |
| 완전성 | 가격 미기재, 스펙 누락, 비교 부재 |
| 신뢰성 | 헤지 어조, 근거 부재, 내부 모순, 과도한 홍보 |
| 가독성 | 조밀한 문단, 정보 분산 |
| 경쟁 포지셔닝 | 약한 가치 제안, 얕은 분석, 약한 사회적 증거, 뒷자리 위치 |
| 최신성 | 최신 대 구형 날짜, 무날짜 대 구형, 최신 대 무날짜 |
표 1. 18개 콘텐츠 요인의 6개 범주 [1].
실행 규모는 요인당 2,400회, 모델당 42,000회, 6개 모델 합쳐 252,000회예요 [1]. 요인당 80개 시나리오에 질의 표현을 3가지로 바꾸고 제시 순서를 양방향으로 돌려 5번씩 반복했어요. 위치 편향과 친숙도 편향을 콘텐츠 효과에서 떼어내려는 통제예요. 응답 중 정확히 URL 1개를 인용한 경우가 86.4%였고, 두 변형 어느 쪽과도 맞지 않는 인용은 회귀에서 제외했어요 [1].
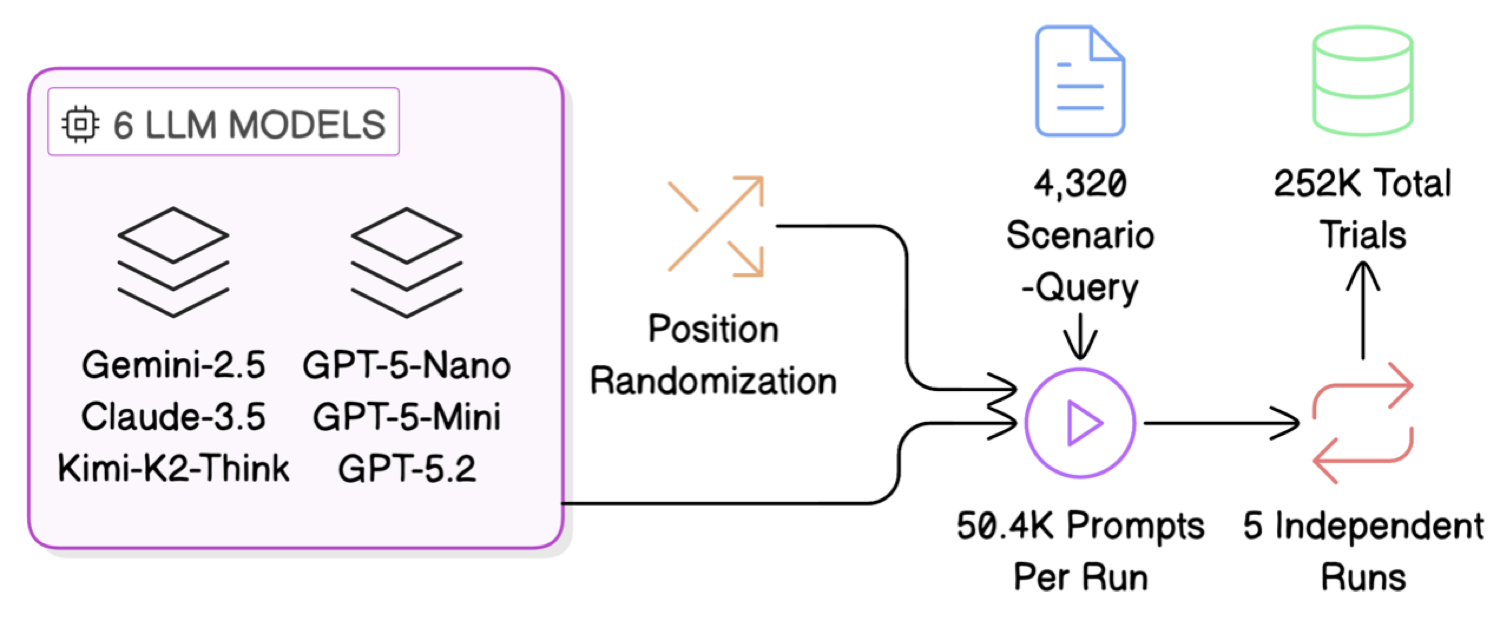
그림 2. 6개 LLM에 위치 무작위화를 적용해 4,320개 시나리오-질의를 런당 50.4K 프롬프트로 5회 반복, 총 252,000회 시행한 실험 규모 [1].
효과 크기는 로지스틱 혼합효과모델(GLMM)로 요인마다 따로 추정했어요.
은 요인이 우세한 변형(A)이 인용된 사건이고, 는 그 요인의 처치 여부예요. 와 는 시나리오와 시나리오 곱하기 순서 조합에 걸린 랜덤 절편으로, 같은 시나리오 안의 반복이 서로 닮았다는 점을 보정해요. 최종 효과는 승산비 로 읽는데, 값이 클수록 그 요인을 갖춘 쪽이 인용을 이길 확률이 압도적이라는 뜻이에요. 논문은 OR 100 이상을 '매우 강함', 10–100을 '강함'으로 분류해요 [1].
게이트키퍼 4개: 하나만 무너져도 인용이 사라진다
18개 요인 중 6개 모델 전원에서 승산비 100을 넘긴 요인이 4개였어요. 주제 일치, 가격 명시, 최신 타임스탬프, 컨텍스트 안 1번 위치예요 [1]. 논문은 이 4개를 게이트키퍼라 불러요. 하나라도 실패하면 다른 콘텐츠 강점과 무관하게 인용 확률이 사실상 소멸하기 때문이에요.
| 요인 (우세 대 열세) | Gemini-2.5 | Claude-3.5 | Kimi-K2 | GPT-5-Nano | GPT-5-Mini | GPT-5.2 |
|---|---|---|---|---|---|---|
| 주제 일치 대 불일치 | 1만+ | 1만+ | 1만+ | 221 | 1만+ | 1만+ |
| 가격 명시 대 미기재 | 1만+ | 1만+ | 36.1 | 7.82 | 6.26 | 30.4 |
| 최신 대 구형 날짜 | 1만+ | 1만+ | 68.7 | 14.4 | 1,494 | 1만+ |
| 1번 위치 대 2번 | 1만+ | 1만+ | 1만+ | 2,002 | 1,795 | 1만+ |
표 2. 4대 게이트키퍼의 모델별 인용 승산비(OR). '1만+'는 준분리로 추정이 극단화된 경우로, 정밀한 배율 대신 결정적 우위로만 읽어요 [1].
여기서 두 가지가 실무적으로 중요해요. 하나는 가격이에요. 가격을 명시한 페이지가 안 적은 페이지를 이기는 승산비가 6.26배에서 1만 배 이상이었어요 [1]. "문의 주세요" 식으로 가격을 숨긴 페이지는 단순 정보 누락을 넘어 게이트키퍼 탈락으로 인용에서 빠질 수 있다는 뜻이에요. 다른 하나는 위치인데, 이건 페이지 본문 안의 위치가 아닌, 검색되어 컨텍스트에 들어간 뒤의 슬롯 순서예요 [3]. 즉 검색 노출과 구조 신호로 앞자리를 잡는 게 인용의 전제 조건이에요.
그다음을 가르는 7개, 그리고 무의미했던 포맷
게이트키퍼를 통과한 뒤에는 2차 차별화 요인 7개가 승부를 갈랐어요. 4개 이상의 모델에서 유의했고 승산비는 대체로 2.1에서 243 사이였어요 [1].
| 요인 (우세 대 열세) | 범주 | 승산비 범위 |
|---|---|---|
| 스펙 있음 대 없음 | 완전성 | 8.63–243 |
| 깊은 대 얕은 분석 | 경쟁 포지셔닝 | 3.98–1만+ |
| 확신 어조 대 헤지 | 신뢰성 | 2.67–754 |
| 근거 있음 대 없음 | 신뢰성 | 2.09–1만+ |
| 강한 대 약한 사회적 증거 | 경쟁 포지셔닝 | 2.14–1만+ |
| 질의어 포함 대 누락 | 콘텐츠 적합성 | 5.99–40.0 |
| 비교 있음 대 없음 | 완전성 | 1.61–7.45 |
표 3. 2차 차별화 요인 7개의 모델별 승산비 범위 [1].
반대로 포맷은 거의 무의미했어요. 조밀한 문단 대 정돈된 섹션은 승산비가 0.78–1.68, 정보 분산 대 집약은 1.13–3.87로, 6개 모델에서 일관된 효과가 없었어요 [1]. 논문은 이를 "LLM이 시각적 조직과 무관하게 내용을 파싱한다"는 근거로 읽어요. 다만 이 결과는 구조만 최적화한 GEO-SFE 연구와 직접 충돌하지는 않아요 [4]. GEO-SFE는 한 페이지의 절대 인용 확률을 다뤘고, 이 논문은 두 후보가 이미 경쟁 후보로 올라온 뒤의 상대 선호만 봤으니 층위가 달라요. 포맷은 게이트키퍼를 통과한 다음의 후순위 레버로 보는 게 맞아요.
최신성에서도 흥미로운 서열이 나왔어요. 최신 날짜가 가장 유리하고, 그다음이 무날짜, 오래된 날짜가 최하위였어요 [1]. 날짜를 갱신할 수 없다면 오래된 날짜를 그대로 두기보다 지우는 편이 낫다는 함의예요.
엔진마다 인용 성격이 다르다
4대 게이트키퍼에는 6개 모델이 모두 동의했지만, 그 아래 민감도는 갈렸어요 [1].
| 모델 | 유의 요인 비율 | 성격 |
|---|---|---|
| Kimi-K2 | 83% | 콘텐츠 신호에 가장 민감 |
| GPT 계열 | 중간 | 여러 요인에 점진적으로 반응, 3개 모델 행동 일관 |
| Claude-3.5 | 50% | 선택적 |
| Gemini-2.5 | 33% | 가장 선택적, 반응할 땐 이진적으로 극단 |
표 4. 모델별 콘텐츠 요인 민감도 [1].
Claude와 Gemini는 소수 요인만 보되 그 요인이 임계를 넘으면 사실상 결정적으로 반응하고, Kimi와 GPT 계열은 더 많은 요인에 점진적으로 반응해요. GPT-5-Nano, Mini, 5.2 세 모델의 행동이 서로 닮았다는 점에서, 논문은 인용 성향을 정하는 건 모델 크기보다 아키텍처라고 봐요 [1]. 타깃 엔진이 Gemini나 Claude라면 게이트키퍼 4개 충족 여부가 이진 스위치처럼 작동하니 거기 집중하고, GPT나 Kimi 계열이라면 2차 차별화까지 쌓는 편이 보상이 커요.
이 실험이 못 본 것
논문 스스로 세 한계를 밝혀요 [1]. 첫째, 후보를 정확히 2개로 고정했어요. 실제 RAG는 5–10개 이상을 검색하는데, 요인 하나만 격리하려고 2후보로 줄였으니 이 결과는 통제된 슬레이트 위의 쌍대 선호이지 다중 문서 완전 경쟁은 아니에요. 둘째, 브랜드와 발행처를 전부 익명화했어요. 그래서 실서비스가 유명 브랜드나 신뢰 도메인을 선호하는 잔여 효과는 이 연구에 아예 반영되지 않아요. 셋째, 시드 큐레이션과 익명화에 GPT-4o가 관여했으니, 이 결과를 "모델의 전반적 글쓰기 품질 판단"으로 확대 해석하면 안 돼요.
특히 두 번째 한계는 실무 해석에서 중요해요. 이 논문은 "콘텐츠가 인용을 따내는 조건"을 정밀하게 보여주지만, "어느 도메인이 신뢰받는가"라는 질문에는 설계상 답할 수 없어요. 브랜드와 도메인 권위 효과는 102개 브랜드를 실측한 GEO at Scale 연구 같은 별도 근거로 봐야 해요.
AEO/GEO 실무에 어떻게 쓸까
이 논문은 우선순위가 분명한 체크리스트를 줘요. 순서를 지키는 게 핵심이에요.
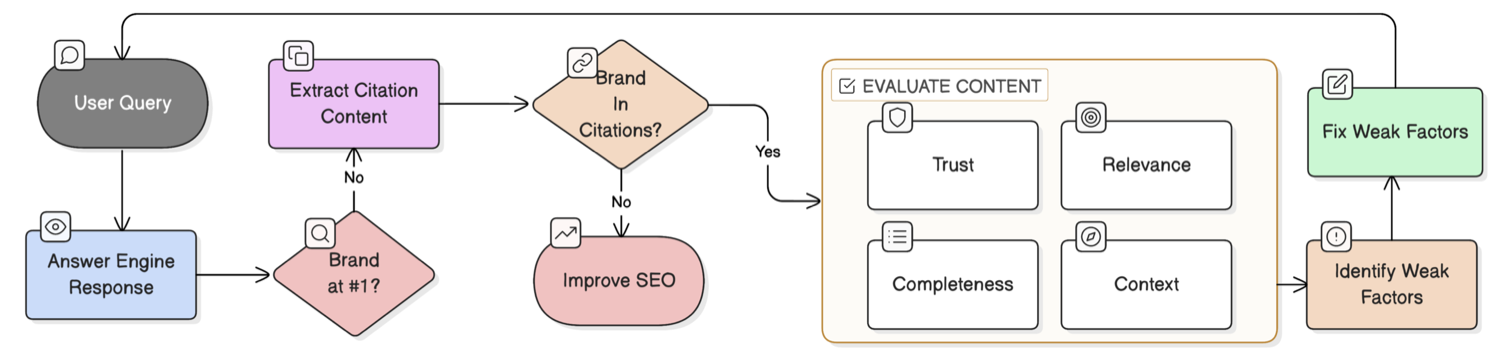
그림 3. 브랜드가 1순위로 추천되지 않을 때의 진단 흐름. 인용 집합에 있으면 신뢰·적합성·완전성·맥락 4범주로 약한 요인을 찾아 고치고, 아예 없으면 검색 노출(SEO)을 먼저 개선해요 [1].
- 게이트키퍼 4개를 먼저 통과시켜요. 주제 일치, 가격 명시, 최신 타임스탬프, 검색 노출로 앞자리 확보. 나머지를 아무리 잘해도 이 4개 중 하나가 무너지면 인용이 사라져요.
- 가격을 숨기지 말아요. 가격 미기재는 단순 누락을 넘어 게이트키퍼급 손실이에요. 제품과 서비스 페이지에 가격이나 최소한 가격대를 명시하는 편이 유리해요.
- 날짜를 관리해요. 갱신할 수 없는 오래된 날짜라면 지우는 편이 낫고, 갱신할 수 있으면 최신 타임스탬프를 노출해요.
- 그다음에 완전성과 확신도를 쌓아요. 스펙 표와 경쟁 대안 비교를 넣고, "아마도"나 "일 수도 있어요" 같은 헤지 어조를 단정적 근거 제시로 바꾸면 2차 차별화에서 승산비가 크게 올라요.
- 포맷 미세조정은 후순위로 미뤄요. 문단을 나누고 강조를 칠하는 작업은 게이트키퍼를 통과한 다음에 하는 마무리예요.
TRAIL 관점에서 이 논문은 진단 체계에 빈틈을 드러내요. 가격 명시와 타임스탬프 관리는 게이트키퍼급 신호인데도, 지금까지 대부분의 GEO 체크리스트가 이를 구조나 권위 신호만큼 비중 있게 다루지 않았어요. AI 검색 최적화를 진단할 때 "가격이 페이지에 노출되는가"와 "날짜가 최신인가"를 상위 점검 항목으로 올릴 근거가 생긴 셈이에요. 인용을 결정하는 요인을 상관관계가 아니라 통제 실험으로 분리했다는 점에서, GEO-16의 상관 기반 진단이나 C-SEO Bench의 효과 검증과 함께 읽으면 인용 최적화의 그림이 한층 또렷해져요.
자주 묻는 질문
AI 답변에 인용되는 데 가장 중요한 건 뭔가요?
주제 일치, 가격 명시, 최신 타임스탬프, 컨텍스트 안 앞자리 이 4가지예요. 논문은 이를 게이트키퍼라 부르는데, 6개 LLM 전원에서 인용 승산비(OR)가 100을 넘었고, 이 중 하나라도 무너지면 다른 강점과 무관하게 인용 확률이 사실상 0으로 떨어졌어요.
제품 페이지에 가격을 안 적으면 AI 검색에 불리한가요?
네, 생각보다 크게 불리해요. 가격을 명시한 페이지가 안 적은 페이지를 이기는 승산비가 모델에 따라 6.26배에서 1만 배 이상이었어요. '문의 주세요' 식으로 가격을 숨기는 페이지는 단순 누락을 넘어 게이트키퍼 탈락으로 인용에서 빠질 수 있어요.
AI 인용에 글 구조나 포맷이 중요한가요?
이 경쟁 실험에서는 거의 무관했어요. 조밀한 문단 대 정돈된 섹션, 정보 분산 대 집약 같은 포맷 차이는 승산비가 1 근처(0.78–3.87)로 통계적으로 일관된 효과가 없었어요. 다만 이건 '두 후보가 이미 경쟁할 때의 상대 선호'를 본 결과라, 절대 인용 확률을 다룬 다른 연구와는 층위가 달라요.
엔진마다 인용 기준이 다른가요?
세부는 달라요. Kimi-K2는 18개 요인 중 83%에 반응할 만큼 콘텐츠 신호에 민감했고, Gemini-2.5는 33%만 봤지만 반응할 땐 이진 스위치처럼 극단적이었어요. 단 4대 게이트키퍼에는 6개 모델이 모두 동의해서, 이건 모델을 가리지 않는 보편 신호로 볼 수 있어요.
참고자료
- [1]Vishwakarma, Kumar & Jamidar, "What Gets Cited: Competitive GEO in AI Answer Engines", SIGIR 2026
- [2]Aggarwal et al., "GEO: Generative Engine Optimization", KDD 2024
- [3]Liu et al., "Lost in the Middle: How Language Models Use Long Contexts", TACL 2024
- [4]Yu et al., "Structural Feature Engineering for Generative Engine Optimization", arXiv 2026
요약
- Sprinklr 연구진이 6개 LLM에 18개 콘텐츠 요인을 붙여 252,000번 물은 통제 실험으로, 두 후보가 경쟁할 때 무엇이 인용을 결정하는지 요인별로 분리했어요.
- 주제 일치·가격 명시·최신 날짜·앞자리 4개가 게이트키퍼로, 6개 모델 전원에서 승산비 100 이상이고 하나만 실패해도 인용이 사라졌어요.
- 스펙·비교 완전성과 확신 어조·근거 제시는 승산비 2.1–243의 2차 차별화 요인이었고, 게이트키퍼를 통과한 뒤에만 의미가 생겼어요.
- 문단 밀도나 정보 배치 같은 포맷은 이 경쟁 설계에서 통계적으로 거의 무의미했어요.
- 가격 미기재와 타임스탬프 관리는 지금까지 GEO 체크리스트에서 과소평가된, 비용 대비 효과가 큰 레버예요.
이 글처럼 AI가 답할 키워드 전략을 자동으로 세워보세요
TRAIL Search가 브랜드가 AI 검색에 어떻게 노출되는지 진단하고, 어떤 콘텐츠를 써야 인용되는지 처방해요.
AI 검색 가시성 진단하기