구조만 바꿔도 AI 인용이 오를까? 헤딩·문단 길이·문서 골격 실증
한 문장도 다시 쓰지 않고 배치·포맷·강조 구조만 최적화하는 생성형 엔진 최적화
GEO-SFE는 콘텐츠의 의미를 한 글자도 다시 쓰지 않고, 헤딩·문단·리스트·강조 같은 구조만 최적화해 AI 검색 인용률을 평균 17.3% 올린 생성형 엔진 최적화 방법이에요. 도쿄대·쓰쿠바대 연구진이 제안했고, 구조를 Macro·Meso·Micro 세 층위로 분해해 각 층위의 인용 기여도와 최적 수치 범위를 처방으로 내놓았어요 [1]. 같은 문제를 콘텐츠 피처 최적화로 푼 FeatGEO의 짝꿍 연구인데, FeatGEO가 '무엇을 담을지'를 다뤘다면 이 논문은 '어떻게 배치할지'를 파고들어요.
Perplexity·구글 AI 개요 같은 생성형 검색은 링크를 나열하는 대신, 검색된 여러 페이지에서 답을 합성하며 일부만 골라 인용해요. 그래서 가시성은 순위가 아니라 인용 여부로 정해져요. "AI가 이 답을 만들 때 왜 다른 페이지 대신 우리를 인용할까"에 답하는 게 GEO이고, 그 문제의 정의와 지표는 GEO 원전 논문에서 다뤘어요 [3].
왜 '무엇을 쓰는가'만으로는 부족할까
기존 GEO 연구는 거의 전부 의미 내용을 손봤어요. 통계를 추가하거나 권위적 표현을 넣거나 인용문을 붙이는 식으로 '무엇을 쓰는가'를 바꿔 인용률을 최대 40%까지 올렸죠 [1][3]. 그런데 같은 정보라도 어떻게 배치하고 포맷하고 강조하는가가 인용을 얼마나 바꾸는지는 거의 탐구되지 않은 영역이었어요.
이게 중요한 이유가 있어요. LLM은 구조화된 텍스트를 읽을 때 의미가 밀집된 영역에 주의를 집중하는데, 구조가 흐트러진 텍스트에서는 주의가 분산되고 성능이 떨어져요 [1]. 즉 헤딩 구조, 정보의 앞부분 배치, 리스트와 표, 문단 길이 같은 구조적 선택이 '어떤 페이지를 인용할까'라는 결정에 직접 개입해요. 논문은 여기서 출발해요. 의미(semantic)는 보존하고 구조(structure)만 최적화하면 인용이 얼마나 오를까.
GEO-SFE: 구조를 세 층위로 분해한다
핵심 발상은 구조를 세 층위로 나눠 각각을 정량 지표로 모델링하는 거예요. 문서 전체 골격을 다루는 Macro, 문단·포맷 단위의 Meso, 토큰 단위 강조인 Micro로 분해하고, 각 지표에 최적 목표 범위를 붙였어요 [1].
| 층위 | 피처 | 지표 | 최적 목표 |
|---|---|---|---|
| Macro | 헤딩 계층 깊이 | 3–5 | |
| Macro | 섹션 균형 | = 레벨별 섹션 비율 | ≈ 0.3 ± 0.1 |
| Macro | 구조 규칙성 | (섹션 길이) | 높게(균일) |
| Macro | 전이 일관성 | = 인접 섹션 유사도 | 높게 |
| Macro | 내부 링크 밀도 | = 내부링크/콘텐츠 단위 | 0.15–0.20, 경로 <3홉 |
| Meso | 문단 길이 | (단어) | 150–300 단어 |
| Meso | 청크 주제 일관성 | = 엔트로피 | 높게 |
| Meso | 포맷 다양성 | = 고유 포맷/콘텐츠 단위 | 0.25–0.35 |
| Meso | 콘텐츠 밀도 | = 정보 단위/토큰 | 적정 |
| Micro | 강조 마커 분포 | = 강조 토큰/전체 토큰 | 0.05–0.10 |
| Micro | 전략적 배치 | = 위치 가중 강조 | 첫머리 2.0× / 경계 1.5× |
| Micro | 강조 위계 | 경험적 가중치 | bold 1.8 > italic 1.3 > underline 1.0 |
| Micro | 가독성 | (Flesch-Kincaid) | 적정 |
표 1. GEO-SFE의 세 층위 13개 구조 피처와 최적 목표.
콘텐츠 의 구조는 세 층위 피처 추출 함수로 하나의 벡터가 돼요 [1].
이제 목표는 의미를 유지하면서 인용 가시성을 최대로 만드는 구조 변환 를 찾는 거예요. 의미 보존이 제약으로 걸려 있어서, 변환된 콘텐츠 의 의미가 원본과 같아야 해요 [1].
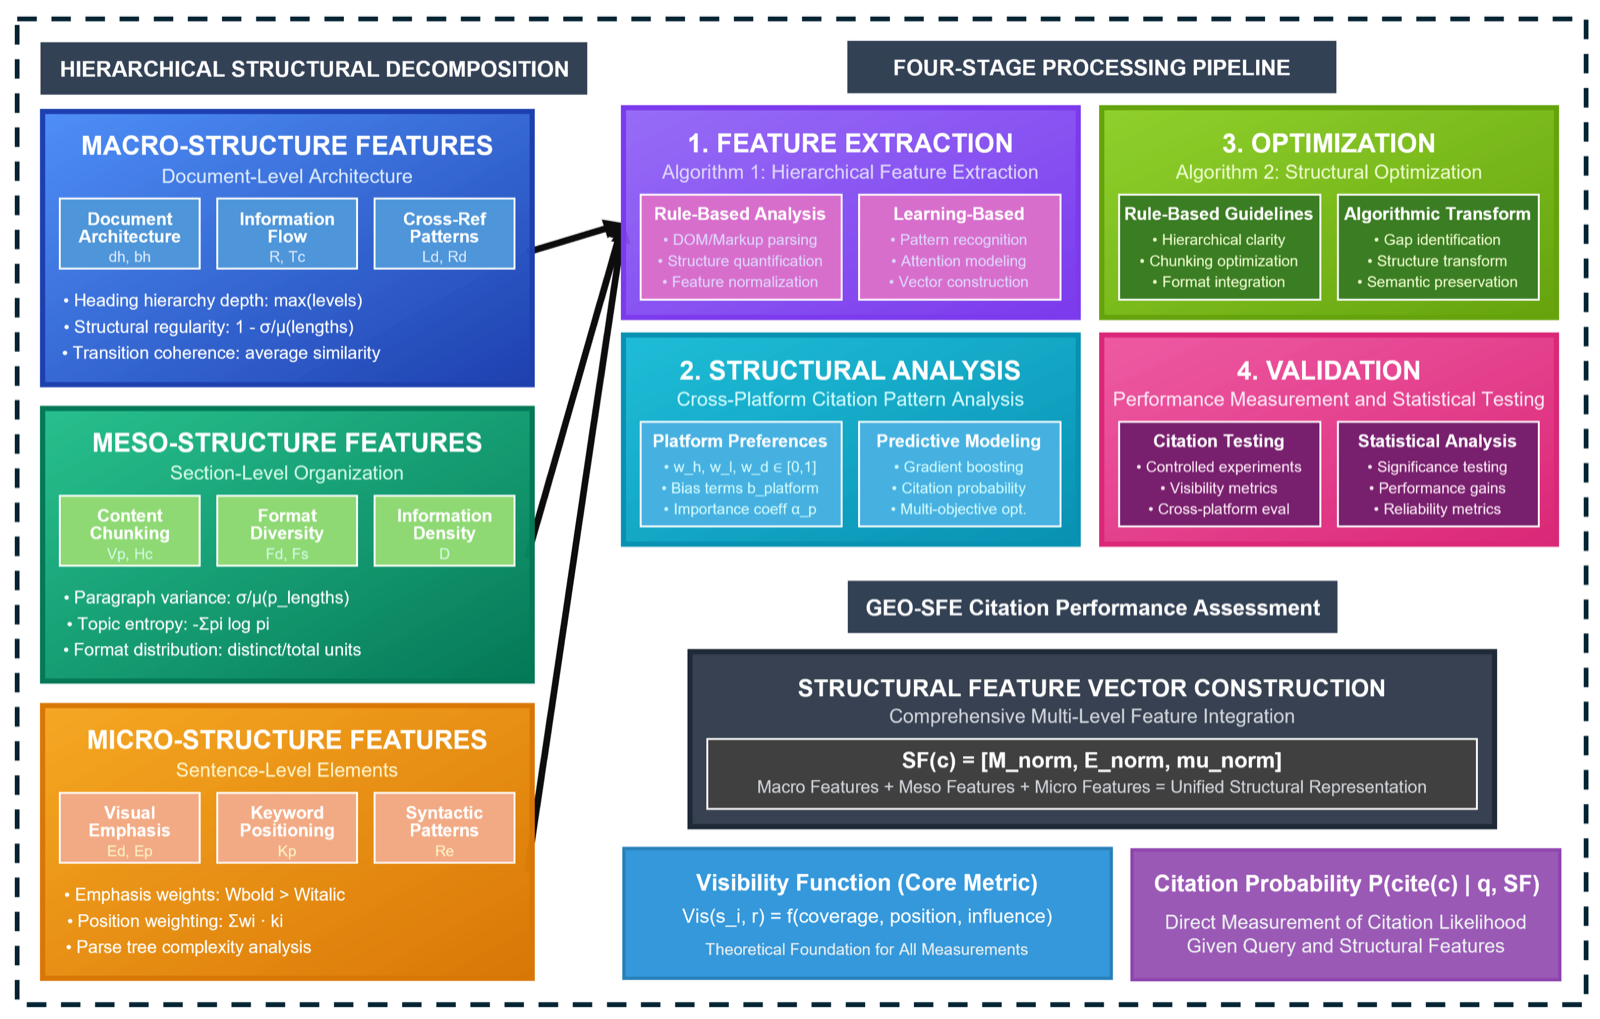
그림 1. GEO-SFE 프레임워크: 세 층위 구조 분해와 4단계(추출·분석·최적화·검증) 파이프라인.
변환은 Macro에서 Micro로 계층적으로 진행되고, 각 단계마다 의미 유사도가 임계치를 넘는지 확인해요. 문장 임베딩 유사도 0.95, 문단 0.70, 문서 JS-divergence 0.15 같은 임계로 의미가 훼손되면 그 변환은 되돌려요 [1][5].
인용은 어떻게 측정하나
구조 최적화의 효과를 재려면 인용을 정량화해야 해요. 논문은 소스 의 가시성을 커버리지·위치·영향력 세 요소의 함수로 정의해요 [1].
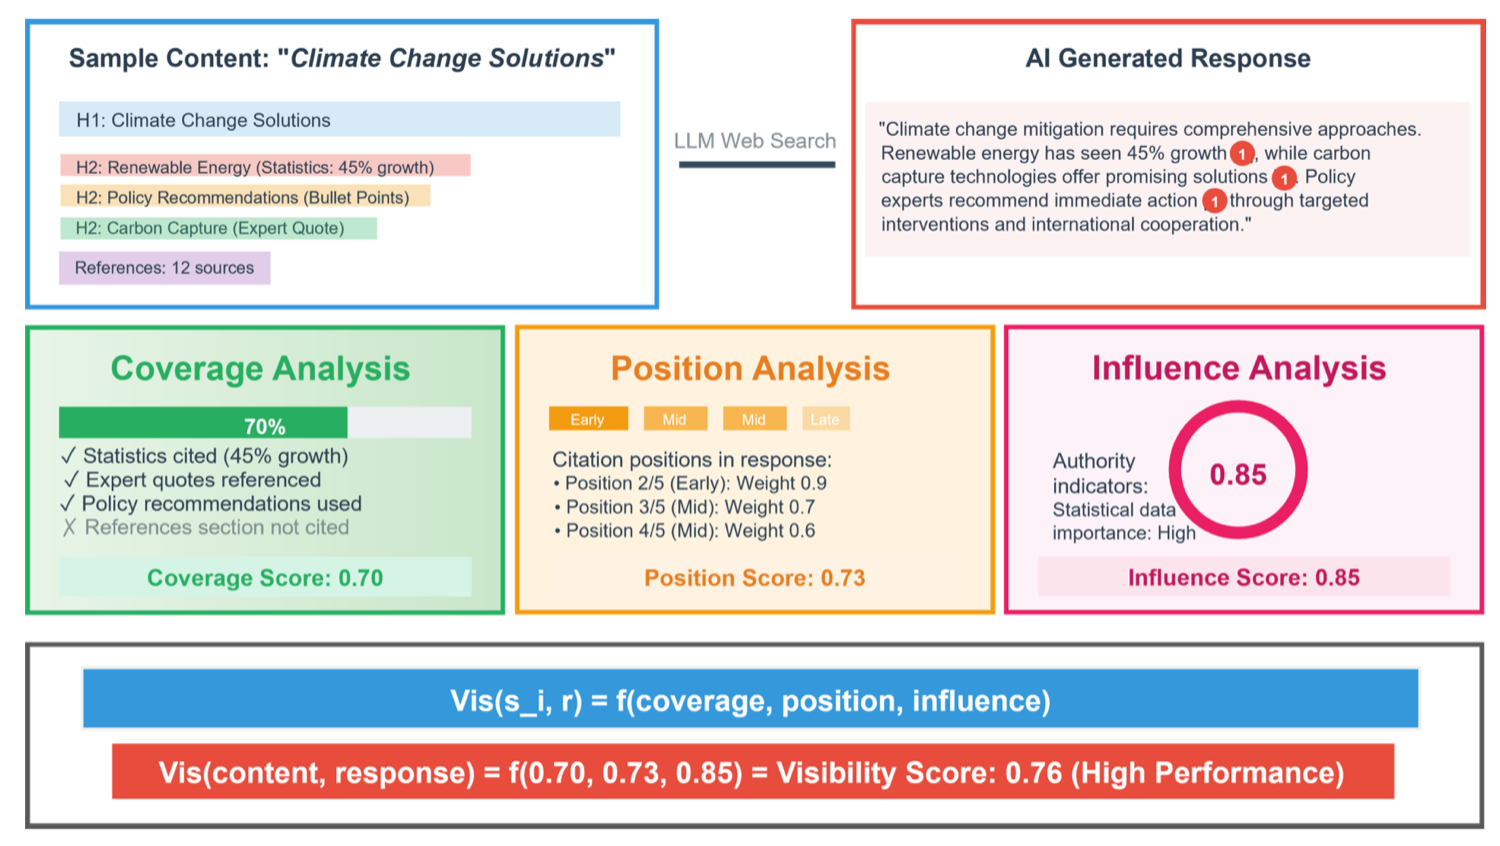
그림 2. 가시성 평가 워크플로: 커버리지·위치·영향력을 분해해 최종 가시성 점수로 합성.
실제 평가 지표는 두 가지예요. 인용률(Citation Rate) 은 전체 질의 중 콘텐츠가 인용된 비율이고, 가시성 점수(Visibility Score) 는 세 요소를 가중 합해요 [1].
평가는 GEO-bench에서 6개 도메인(전기·건강·기술·금융·여행·과학) 200개 글, 377개 실제 질의로 구성했고, 각 글은 baseline과 GEO-SFE 최적화 버전을 6개 엔진에 던져 총 2,400개 테스트 케이스를 봤어요. 의미 보존은 BGE-M3 임베딩으로 확인했고 평균 유사도가 0.843이라, 구조를 바꿔도 의미는 유지됐다는 걸 검증했어요 [1][5].
무엇이 인용을 만드는가
전체 효과부터 보면, 구조만 최적화해서 인용률이 45.0%에서 52.8%로 17.3% 상대 개선됐어요(p < 0.001, Cohen's d = 0.64로 중상 효과) [1]. 한 문장도 다시 쓰지 않고 얻은 결과예요.
그럼 세 층위 중 어디가 인용을 만들까요. 각 층위를 최적화에서 하나씩 빼서 인용률이 얼마나 떨어지는지로 기여도를 쟀어요 [1].
| 계층 | 제거 시 CR 하락 | 총 인용 향상 기여도 |
|---|---|---|
| Macro (문서 골격) | −3.5%p | 44.9% |
| Meso (정보 청킹) | −3.1%p | 39.7% |
| Micro (시각적 강조) | −1.2%p | 15.4% |
표 2. 계층별 인용 향상 기여도(Ablation). Full 52.8% / Baseline 45.0%.
문서 골격(Macro)과 정보 청킹(Meso)이 인용의 84.6%를 좌우해요. bold·italic 같은 강조(Micro)는 15.4%로 보조적이었어요. 즉 굵게 칠하는 것보다 구조를 짜는 게 압도적으로 중요하다는 뜻이에요. 개별 구조 선택의 측정값도 이 그림을 뒷받침해요 [1].
- 리스트·표는 동일 산문 대비 추출 정확도 +43%. 비교·스펙·단계·조건은 구조화 포맷으로 주면 LLM이 훨씬 잘 뽑아내요. 단 포맷 다양성 가 0.35를 넘으면 가독성이 무너져 역효과예요.
- 문단 길이는 300단어를 넘으면 중간 구간 주의가 31% 떨어지고, 150단어 미만이면 정보 흐름이 끊겨 인용 확률이 23% 낮아져요. 최적은 150–300단어.
- 헤딩 깊이는 5단계를 넘으면 구조 토큰 과다로 주의가 분산되고, 3단계 미만이면 조직화 단서가 부족해요. 최적은 3–5레벨.
- 강조 배치는 문장 첫머리가 일반 위치보다 2.0배 주의를 받고, 강조 매체는 bold(1.8) > italic(1.3) > underline(1.0) 순으로 효과가 커요.
강조의 전략적 배치는 위치 가중으로 모델링돼요. 문장 첫머리에 둔 강조가 가장 크게 반영돼요 [1].
엔진 아키텍처마다 좋아하는 구조가 다르다
흥미로운 부분은 엔진 아키텍처마다 반영하는 구조가 다르다는 거예요. 논문은 생성 엔진을 검색·생성이 맞물리는 방식으로 세 패러다임으로 나눴어요 [1].
| 아키텍처 | 대표 엔진 | 우선 구조(가중치) |
|---|---|---|
| Search-then-Synthesize | Google SGE·Bing | 메타구조 0.45 / 앞부분 밀도 0.30 / 계층 깊이 0.25 |
| Iterative Refinement | Perplexity·Phind | 교차참조 0.41 / 계층 폭·깊이 0.35 / 질의유발 키워드 0.24 |
| Integrated Search-Generation | ChatGPT·Claude | 청크 독립성 0.38 / 포맷 다양성 0.35 / 적극적 청킹 0.27 |
표 3. 아키텍처별 구조 가중치(Table II). 엔진의 검색·생성 타이밍이 선호 구조를 정한다.
각 아키텍처의 인용 확률은 구조 벡터에 아키텍처별 가중치를 곱한 로지스틱으로 예측해요 [1].
여러 엔진을 동시에 노릴 땐 타깃 분포로 가중한 다목적 최적화로 풀어요 [1].
실제 향상 폭도 아키텍처마다 달랐어요. 세 패러다임 모두 유의하게 개선됐지만, 일괄 검색형과 통합 생성형에서 특히 컸어요 [1].
| 아키텍처 | Baseline CR | 최적화 CR | 향상 |
|---|---|---|---|
| Search-then-Synthesize (SGE·Bing) | 43.7% | 52.1% | +19.2% |
| Iterative Refinement (Perplexity·Phind) | 52.3% | 59.6% | +14.0% |
| Integrated Search-Generation (ChatGPT·Claude) | 39.1% | 46.8% | +19.7% |
표 4. 아키텍처별 인용률 개선(Table IV, 모두 p < 0.001).
구조만 바꿔도 품질까지 오른다
구조 최적화가 인용만 올리고 사람이 읽는 품질은 해치지 않을까 걱정될 수 있어요. 결과는 반대였어요. Gemini 2.5 Pro로 평가한 G-Eval 7차원 주관 품질이 평균 18.5% 향상됐어요 [1][4].
| 차원 | 향상 |
|---|---|
| Influence (영향력) | +32.0% |
| Click Probability (클릭 확률) | +31.4% |
| Subjective Position (주관적 위치) | +19.4% |
| Relevance (관련성) | +19.3% |
| Subjective Count (주관적 빈도) | +12.5% |
| Uniqueness (고유성) | +10.8% |
| Diversity (다양성) | +7.2% |
표 5. G-Eval 7차원 주관 품질 향상(평균 +18.5%).
영향력과 클릭 확률이 30% 넘게 오른 게 눈에 띄어요. Macro 골격이 서사적 권위를 세우고 Meso 포맷이 시각적 매력을 높인 결과라고 논문은 해석해요 [1]. 구조를 명확히 짜면 AI가 인용하기도, 사람이 읽기도 좋아진다는 뜻이에요.
이 방법의 한계
논문은 스스로 네 가지 한계를 밝혀요 [1].
- 표본 규모: 200개 글로 평가했어요. 크로스 플랫폼으로 2,400개 케이스를 봤지만, 도메인·언어를 더 넓히면 최적 수치가 달라질 수 있어요.
- 임베딩 의존: 의미 보존을 BGE-M3 하나로 검증했어요. 다른 임베딩 모델은 다른 임계치를 줄 수 있어요.
- 인과 미검증: LLM 인용 메커니즘이 블랙박스라, 주의(attention) 가설을 인과적으로 확증하진 못했어요. 측정된 상관을 근거로 처방을 냈어요.
- 일반화: 비영어 콘텐츠나 고도로 전문적인 도메인에서의 전이성은 아직 보이지 않았어요.
TRAIL 관점: 인용은 설계의 문제
이 연구의 교훈은 우리가 매일 다루는 문제와 곧장 닿아요. AEO·GEO에서 성과는 결국 'AI가 답을 만들 때 어떤 소스에 기댔나'이고, TRAIL Search는 그 인용·점유율(SoV) 신호를 추적해요. FeatGEO가 '무엇을 담을지'를 피처로 최적화했다면, 이 논문은 그 내용을 '어떻게 배치할지'를 더해요. 둘을 합치면 실무 체크리스트가 선명해져요.
- 골격을 먼저: 헤딩을 3–5단계로 세우고 섹션 분량을 고르게 나눠요. 기여도가 가장 큰 축이에요(Macro 44.9%).
- 답을 앞에: 각 섹션 첫 문장에 결론·정의·수치를 먼저 배치해요. 일괄 검색형 엔진이 앞부분 밀도를 크게 봐요.
- 비교는 표로: 스펙·단계·조건은 산문 대신 리스트나 표로 줘요. 추출 정확도가 43% 올라요.
- 문단은 150–300단어: 너무 길면 중간이 무시되고, 너무 짧으면 흐름이 끊겨요.
- 강조는 5–10%만: 핵심 수치를 bold로, 그것도 전체의 5–10%만. 남발하면 신호가 죽어요.
- 엔진을 정해 조율: Perplexity를 노리면 교차참조를, ChatGPT·Claude를 노리면 청크 독립성을 강화해요.
결국 GEO-SFE는 GEO를 '글자 고치기'에서 '구조 세우기'로 옮겨 놓았어요. 무엇을 담을지 정한 뒤엔 어떻게 배치할지가 인용을 만들고, 그 설계는 사람이 읽는 품질까지 함께 끌어올려요. 측정과 설계가 한 쌍으로 맞물릴 때, AI 답변 속 우리 자리는 표면 기교보다 구조로 넓어져요.
2026년 9월 업데이트
이 논문의 Macro·Meso·Micro 3층 분해는 실무 점검 순서로 바로 옮길 수 있어요. 논문이 보고한 기여도는 Macro 44.9% · Meso 39.7% · Micro 15.4%로, 문서 골격과 청킹이 인용의 대부분을 좌우하고 시각적 강조는 보조예요. 그래서 굵게 칠하기보다 헤딩 구조와 문단 길이를 먼저 잡는 게 효율이 좋아요. 한 가지 흔한 조언은 근거가 약해요. 결론부에 핵심을 다시 몰아 두라는 처방은 우리 자체 실측에서 지지되지 않아서, 앞부분 배치를 우선하는 편이 안전해요.
자주 묻는 질문
GEO-SFE는 기존 GEO와 뭐가 다른가요?
기존 GEO는 대부분 '무엇을 쓰는가', 즉 통계·인용·권위 표현 같은 의미 내용을 고쳐요. GEO-SFE는 의미를 그대로 둔 채 '어떻게 배치·포맷·강조하는가'라는 구조만 최적화해요. 한 문장도 다시 쓰지 않고 헤딩 깊이·문단 길이·리스트·bold만 조정해서 인용률을 17.3% 올렸어요.
어떤 구조가 인용에 가장 크게 기여하나요?
문서 골격을 잡는 Macro 층위가 전체 향상의 44.9%로 가장 컸고, 정보 청킹인 Meso가 39.7%, bold·italic 같은 시각적 강조 Micro가 15.4%였어요. 골격과 청킹이 인용의 84.6%를 좌우해서, 굵게 칠하기보다 구조를 짜는 게 압도적으로 중요해요.
엔진마다 좋아하는 구조가 다른가요?
네. Google SGE·Bing 같은 일괄 검색형은 메타구조 명확성과 앞부분 밀도를, Perplexity·Phind 같은 반복 검색형은 교차참조와 계층 폭을, ChatGPT·Claude 같은 통합 생성형은 청크 독립성과 포맷 다양성을 더 크게 반영해요. 타깃 엔진에 맞춰 목표 구조를 다르게 잡아요.
구조를 바꾸면 사람이 읽는 품질은 나빠지지 않나요?
오히려 좋아졌어요. G-Eval 7차원 주관 품질이 평균 18.5% 올랐고, 영향력(+32.0%)과 클릭 확률(+31.4%)이 가장 크게 올랐어요. 단 리스트·표 비중이 0.35를 넘거나 문단이 300단어를 넘으면 가독성이 무너져서, 최적 구간 안에서 조정하는 게 핵심이에요.
참고자료
- [1]Yu et al., "Structural Feature Engineering for Generative Engine Optimization: How Content Structure Shapes Citation Behavior", arXiv 2026
- [2]Liu & Xu, "Think Before Writing: Feature-Level Multi-Objective Optimization for Generative Citation Visibility (FeatGEO)", ACL 2026
- [3]Aggarwal et al., "GEO: Generative Engine Optimization", KDD 2024
- [4]Liu et al., "G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment", EMNLP 2023
- [5]Chen et al., "BGE M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings", 2024
요약
- GEO-SFE는 콘텐츠의 의미를 그대로 둔 채 구조(배치·포맷·강조)만 최적화해 AI 검색 인용률을 평균 17.3% 올린 실증 연구예요.
- 구조를 Macro(문서 골격)·Meso(정보 청킹)·Micro(시각적 강조) 세 층위로 분해하고, 각 층위의 지표와 최적 수치 범위를 처방으로 제시해요.
- 인용을 좌우하는 건 Macro(44.9%)와 Meso(39.7%)였고, bold·italic 같은 강조(15.4%)는 보조적이에요. 골격과 청킹이 84.6%를 만들어요.
- 헤딩 3–5단계·문단 150–300단어·리스트/표(추출 +43%)·강조 5–10%·앞부분 배치 같은 수치 처방이 6개 엔진에서 일관되게 통했어요.
- 엔진 아키텍처마다 반영하는 구조가 달라서, 타깃 엔진에 맞춰 목표 구조를 다르게 잡으면 향상 폭이 더 커져요.
이 글처럼 AI가 답할 키워드 전략을 자동으로 세워보세요
TRAIL Search가 브랜드가 AI 검색에 어떻게 노출되는지 진단하고, 어떤 콘텐츠를 써야 인용되는지 처방해요.
AI 검색 가시성 진단하기