C-SEO Bench: 대화형 SEO는 정말 통할까? 경쟁이 지우는 이득
본문을 아무리 고쳐도 순위는 잘 안 오르고, 통하는 소수 기법마저 모두가 따라 하면 제로섬
대화형 검색 SEO(C-SEO)는 기대만큼 통하지 않아요. 본문을 권위적으로 다듬고 통계·인용을 끼워 넣는 대부분의 기법은 인용 순위를 거의 못 올리고, 일부 도메인에선 오히려 떨어뜨려요. 정작 크게 통한 건 문서를 LLM 컨텍스트 앞자리에 올리는 전통 SEO였고, 그나마 효과 있던 소수 기법마저 모두가 따라 하면 이득이 0으로 수렴하는 제로섬이었어요. NeurIPS 2025 Datasets & Benchmarks 트랙에 실린 C-SEO Bench 가 이걸 2개 태스크·6개 도메인·약 1.9k 쿼리에서 정면으로 측정했어요 [1]. GEO라는 문제의 정의와 지표는 GEO 원전 논문에서 다뤘고, 최적화 방법론은 FeatGEO에서 정리했어요. 이 글은 그 낙관론을 냉정하게 검증하는 회의론 쪽 논문이에요.
Perplexity·구글 AI 개요·ChatGPT 검색 같은 대화형 검색 엔진(CSE)은 순위 목록 대신 답을 합성하며 몇 개 문서만 인용해요. 그래서 SEO도 "내 문서가 답 안에서 더 앞서 인용되게" 본문을 고치는 C-SEO로 옮겨 가는 중이에요 [2]. 문제는 지금까지의 근거가 대부분 나만 최적화하고 경쟁자는 가만히 있는 단일 액터 가정, 그리고 좁은 도메인에서만 나왔다는 점이에요. C-SEO Bench는 이 두 구멍을 메워요 [1].
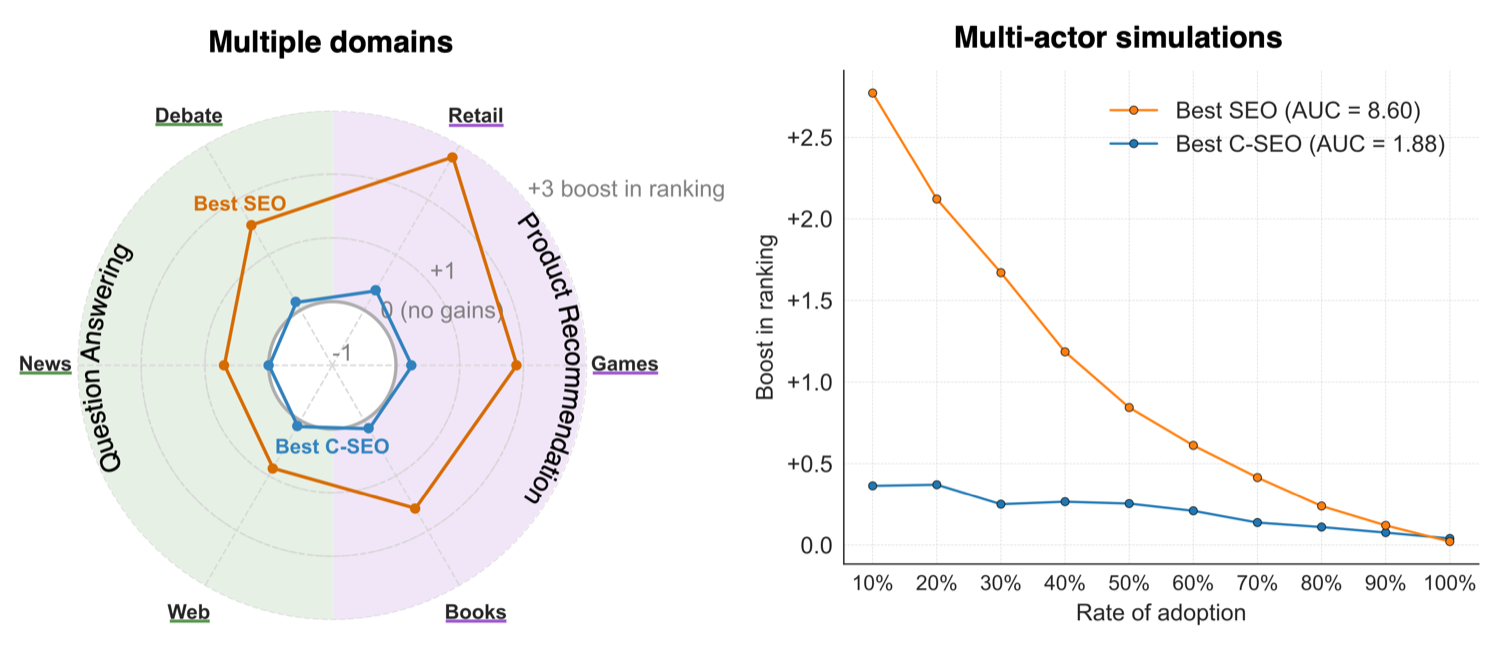
그림 1. 최고 C-SEO 대 최고 SEO. 왼쪽은 6개 도메인 비교(C-SEO는 0 근방), 오른쪽은 채택률에 따른 이득 감소(SEO AUC 8.60 대 C-SEO 1.88).
무엇을 벤치마크했나
C-SEO Bench는 최초의 멀티-태스크·멀티-도메인·멀티-액터 벤치마크예요. 실제 CSE에서 가장 흔한 두 태스크, 즉 제품 추천과 질의응답을 각각 세 도메인으로 나눠 총 6개 도메인을 담았어요. 전부 합치면 약 1.9k 쿼리와 약 16k 문서예요 [1].
| 태스크 | 도메인 | 소스 | 쿼리 | 문서 |
|---|---|---|---|---|
| 제품 추천 | Retail | Amazon | 500 | 5,000 |
| 제품 추천 | Video Games | Steam | 436 | 4,360 |
| 제품 추천 | Books | Google Books | 249 | 2,245 |
| 질의응답 | Web | Brave/Google | 300 | 1,500 |
| 질의응답 | News | Multi-News | 294 | 2,375 |
| 질의응답 | Debate | Liu 2023 | 142 | 880 |
표 1. C-SEO Bench의 2개 태스크·6개 도메인 구성 [1].
테스트한 C-SEO 방법은 고전 기법 8개에 신규 2개를 더한 10개예요. 고전 기법은 권위적 어조(Authoritative)·통계 삽입(Statistics)·인용 추가(Citations)·유창성(Fluency)·희귀 단어(Unique Words)·전문 용어(Technical Terms)·쉬운 언어(Simple Language)·인용구(Quotes)로, GEO 원전에서 제안된 변형들이에요 [2]. 여기에 이 논문이 두 가지를 더했어요 [1].
- Content Improvement: 위 고전 변형 여덟 개를 하나로 묶어 본문을 종합적으로 개선해요.
- LLM Guidance: llms.txt 표준에서 착안해, 문서 맨 앞에 마크다운 요약을 붙여 LLM에 직접 가이드를 줘요 [5].
CSE 역할 LLM은 GPT-4o-mini를 메인으로 쓰고, Claude-3.5-Haiku·o3·o4-mini로 재현했어요. 비교군인 전통 SEO는 본문을 고치는 대신, 문서를 컨텍스트의 특정 위치(Position 1–10)에 강제 배치해서 리트리벌 랭킹을 올리는 상황을 모사해요 [1].
효과는 어떻게 쟀나
측정은 직관적이에요. 효과 있는 C-SEO라면 LLM이 우리 문서를 더 일찍 인용해야 해요. 그래서 문서 하나의 이득을 최적화 전후 인용 순위의 차이로 정의해요. 값이 양수면 순위가 앞당겨진 거예요 [1].
여기서 는 기준선 인용 순위, 는 채택률 에서 C-SEO를 적용한 뒤의 순위예요. 채택률 는 전체 문서 중 몇 %가 같은 기법을 동시에 쓰는지를 뜻해요. 한 방법의 평균 이득은 쿼리와 문서에 대해 평균 내서 구해요 [1].
이득의 통계적 유의성은 우측검정 Wilcoxon signed-rank 검정으로 보고, 여러 방법을 한 도메인에서 함께 비교하니 Holm-Bonferroni 보정으로 다중검정 문제를 눌러요(p<0.05) [1]. 마지막으로 채택률이 미리 정해지지 않은 현실을 반영해, 0%에서 100%까지 이득을 적분한 곡선 아래 면적(AUC)으로 방법의 견고함을 하나의 수로 요약해요 [1].
C-SEO는 대체로 통하지 않는다
결과부터 보면 냉정해요. GPT-4o-mini에서 6개 도메인 × 10개 기법의 54개 조합 중, 통계적으로 유의한 양의 이득은 단 3건뿐이었어요. 그것도 전부 제품 추천 도메인에 몰렸어요. LLM Guidance가 Retail(+0.36)·Video Games(+0.24)에서, Content Improvement가 Retail(+0.18)에서만 유의했고, 질의응답(Web·News·Debate)에서는 사실상 효과가 없었어요 [1].
| 방법 | Retail | Games | Books | Web | News | Debate |
|---|---|---|---|---|---|---|
| Statistics | -0.07 | 0.00 | -0.11 | -0.53 | -0.01 | -0.80 |
| Content Impr. | 0.18 | 0.13 | 0.01 | 0.02 | -0.04 | 0.11 |
| LLM Guidance | 0.36 | 0.24 | 0.14 | 0.10 | 0.00 | 0.15 |
| Best SEO | 2.77 | 1.89 | 1.60 | 0.87 | 0.70 | 1.54 |
표 2. GPT-4o-mini에서의 인용 순위 이득(볼드=Holm-Bonferroni 보정 후 유의) [1].
더 눈에 띄는 건 역효과예요. 고전 기법들은 단순히 무효인 데 그치지 않고, 여러 도메인에서 순위를 유의하게 떨어뜨렸어요. 예를 들어 Statistics는 Debate에서 -0.80, Web에서 -0.53으로 오히려 문서를 뒤로 밀었어요. 논문 표현대로, 대부분의 C-SEO는 "largely ineffective"할 뿐 아니라 자주 순위에 부정적이었어요 [1]. LLM Guidance를 적용한 Retail에서도 문서의 61.0%는 순위가 그대로였고, 나머지도 양·음의 이동이 서로 상쇄됐어요 [1].
진짜 레버는 전통 SEO다
그럼 무엇이 통할까요. 답은 본문 수사가 아니라 검색 랭킹이에요. 문서를 컨텍스트 앞자리에 올리는 것만으로 이득이 압도적이었어요. Position 1 배치는 Retail에서 +2.77, Video Games에서 +1.89의 순위 이득을 줬고, 6개 도메인 전부에서 통계적으로 유의했어요 [1]. 최고 C-SEO 기법인 LLM Guidance Retail(+0.36)과 비교하면 Position 1(+2.77)은 약 7.7배 컸어요.
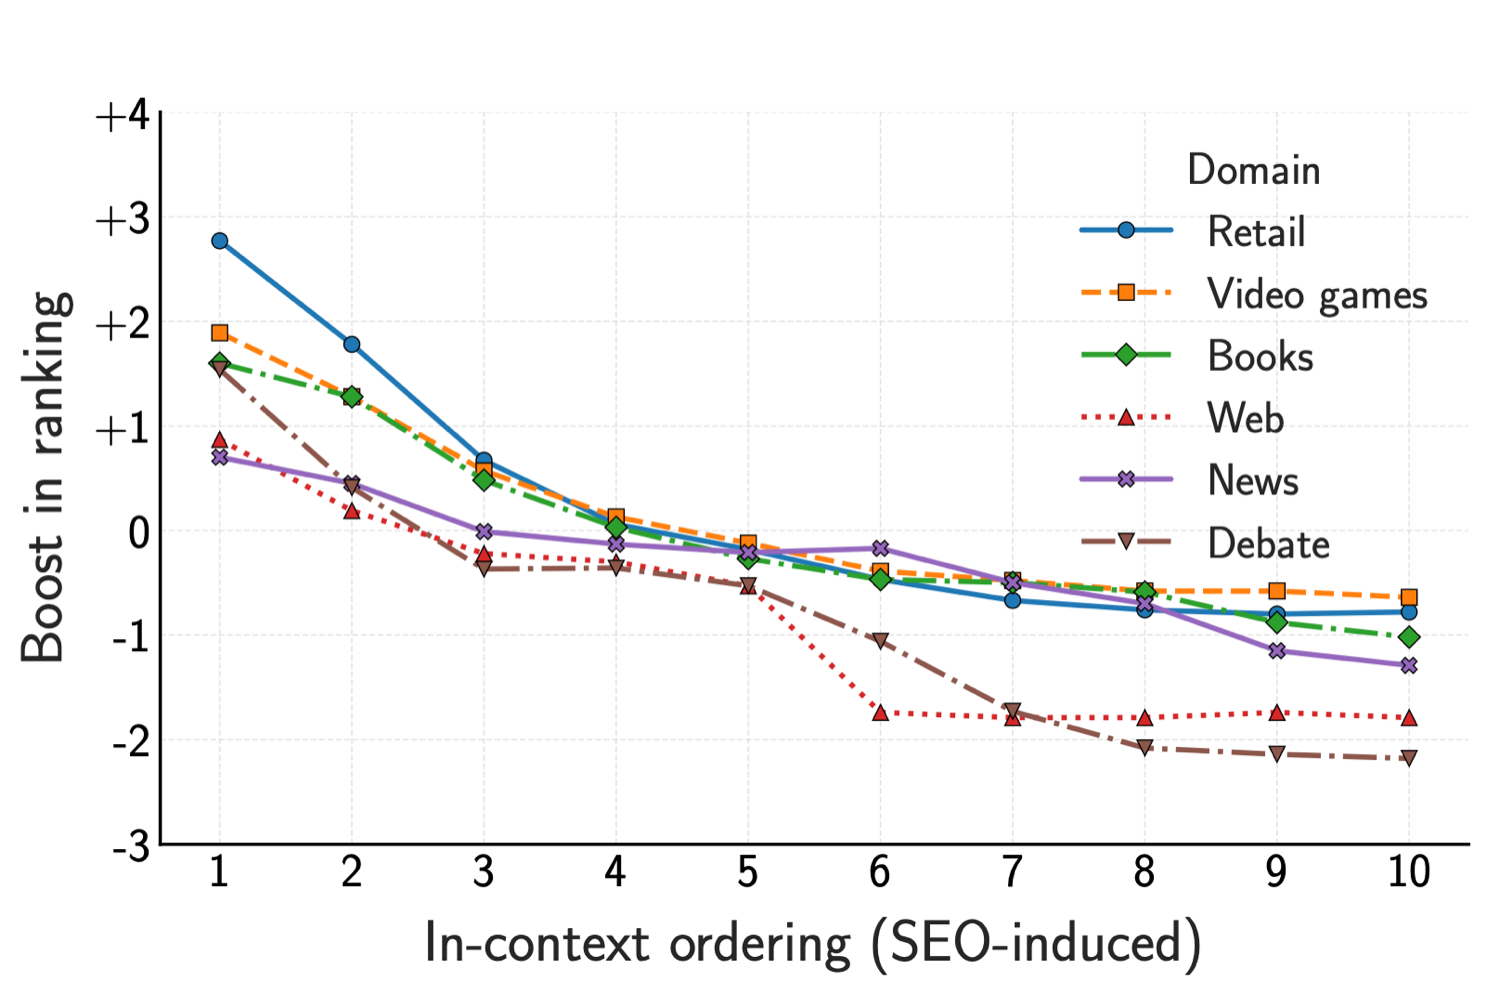
그림 2. 전통 SEO의 힘. 문서를 컨텍스트 앞 위치에 놓을수록 순위 이득이 커지고, 최소 앞 두 자리는 모든 도메인에서 유의했다 [1].
그림 2를 보면 앞 위치의 이득이 뒤로 갈수록 빠르게 사라져요. 논문은 이걸 근거로, 검색·리트리벌로 문서 순서를 결정하는 상류 단계가 본문 편집보다 훨씬 큰 영향을 준다고 결론지어요. C-SEO가 전통 SEO를 대체할 거라던 기대와 정반대로, C-SEO는 전통 SEO의 보완재로만 봐야 한다는 거예요 [1].
모두가 하면 이득은 0으로
효과 있는 소수 기법이라도 안심할 수 없어요. C-SEO는 경쟁 게임이라, 같은 기법을 채택하는 플레이어가 늘수록 이득이 깎여요. 논문은 이걸 제로섬으로 규정해요 [1].
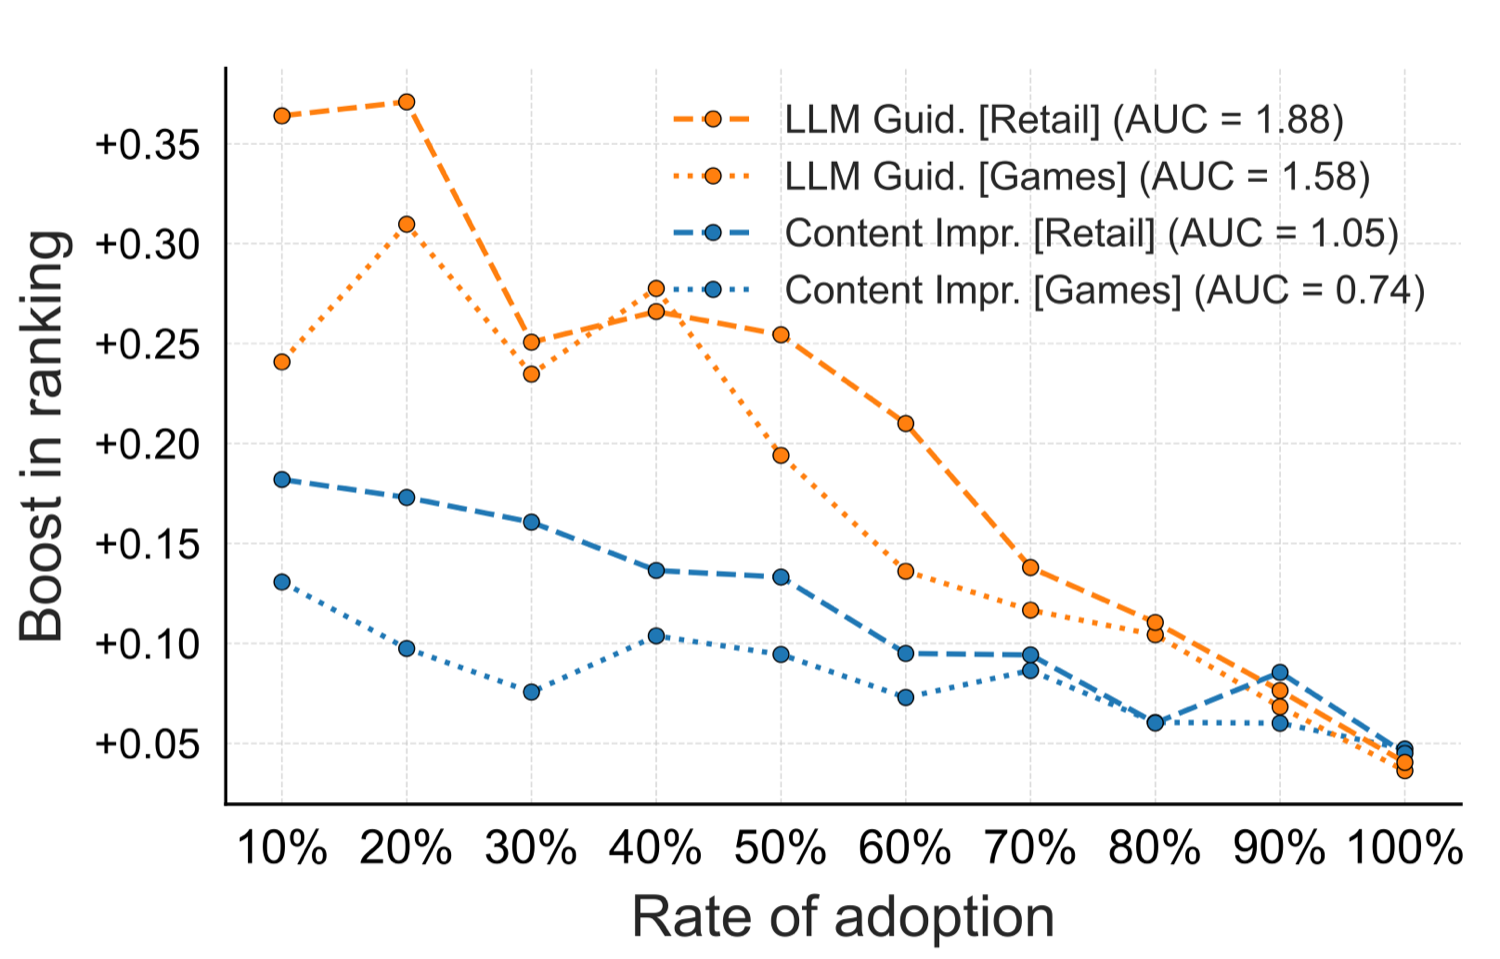
그림 3. C-SEO는 제로섬 게임. 채택률이 오를수록 어답터당 평균 이득이 감소한다(LLM Guidance Retail AUC 1.88, Games 1.58) [1].
Retail에서 LLM Guidance의 이득은 채택률 10%일 때 약 +0.36이었는데, 100%에서는 약 +0.04로 거의 증발했어요. Content Improvement도 비슷하게 앞선 어답터에게만 이득이 쏠렸어요 [1]. 곡선 아래 면적으로 보면 LLM Guidance가 Retail 1.88·Games 1.58로 Content Improvement(1.05·0.74)보다 견고했지만, 방향은 똑같이 우하향이에요. 한 문서의 순위 상승은 다른 문서의 하락에서 나오니, 남보다 먼저 쓴 사람만 이득을 보고 다 같이 쓰면 이득이 사라져요. 선점 프리미엄일 뿐 지속 우위가 아니에요.
모델을 바꾸면 사라진다
GPT-4o-mini에서의 소수 성공조차 엔진을 바꾸면 재현되지 않았어요. Claude-3.5-Haiku에서는 10개 C-SEO 방법 중 단 하나도 유의한 이득을 내지 못했고, 제품 추천 30개 케이스 중 26개가 오히려 순위를 유의하게 떨어뜨렸어요 [1].
| 방법 | Retail | Games | Web | Debate |
|---|---|---|---|---|
| Authoritative | -0.53 | -0.20 | 0.03 | 0.01 |
| LLM Guidance | -0.32 | 0.00 | 0.02 | 0.18 |
| Best SEO | 1.61 | 0.93 | 0.35 | 0.56 |
표 3. Claude-3.5-Haiku에서는 C-SEO 이득이 대부분 음수, 전통 SEO만 유효 [1].
전통 SEO(Best SEO)는 Haiku에서도 여전히 유의하게 통했어요. 즉 앞자리 배치는 엔진이 바뀌어도 견고한 레버지만, 본문 재작성형 C-SEO는 특정 모델에 우연히 맞은 처방이었던 셈이에요. 단일 엔진에서 검증한 C-SEO 효과 주장은 그래서 신뢰하기 어려워요 [1].
이 벤치마크의 한계
논문은 스스로 범위를 좁혀 두고 결과를 해석해요 [1].
- 화이트햇 한정: 프롬프트 인젝션 같은 적대적·블랙햇 조작은 다루지 않아요. 견고성 평가는 별개 문제로 남겨 뒀어요.
- 상용 폐쇄 모델: 실험이 상용 API 모델에 의존해서, 오픈 모델이나 다른 세팅으로의 전이성은 열린 질문이에요.
- SEO와의 상호작용 미탐구: 전통 SEO와 C-SEO를 함께 쓸 때의 시너지·간섭은 후속 과제로 남겼어요.
- 영어·특정 태스크: 데이터가 영어 콘텐츠와 두 태스크에 한정돼, 다른 언어·문화·태스크로의 일반화는 검증되지 않았어요.
TRAIL 관점: 회의는 측정에서 나온다
이 논문은 우리가 매일 다루는 문제를 정확히 겨눠요. AEO·GEO에서도 성과는 결국 "AI가 답을 만들 때 어떤 소스를 인용했나"이고, TRAIL Search는 그 인용·점유율(SoV) 신호를 추적해요. C-SEO Bench의 교훈을 우리 제품 관점의 원칙으로 옮기면 이래요.
- 본문 마사지에 예산을 태우지 않기: 권위·통계·인용 삽입형 처방은 이득이 0 근방이거나 음수예요. ROI가 음수일 수 있으니, 어조·수사 개선을 우선 레버로 팔지 않아요.
- 1순위는 리트리벌 가시성: Position 1이 최고 C-SEO의 약 7.7배였어요. 내 문서를 LLM이 끌어오는 소스 풀 상위로 올리는 전통적 검색 가시성·신뢰도·인덱싱이 진짜 축이에요.
- 엔진별로 나눠 재기: GPT에서 통한 게 Claude에서 0건이었어요. TRAIL Search의 멀티엔진 fan-out으로 기법별 효과를 엔진마다 측정하지 않은 처방은 신뢰하지 않아요.
- 효과는 채택률과 함께 감쇠로 보고: 단일 액터 이득만 자랑하면 과대평가예요. 우리 처방의 효과도 채택률별 감쇠와 유의성까지 붙여 정직하게 보고해요.
결국 C-SEO Bench가 남기는 메시지는 단순해요. 대화형 검색에서 문서를 앞세우는 힘은 표면 문장을 다듬는 데서 나오지 않고, 검색이 그 문서를 얼마나 신뢰해 앞으로 끌어오는지에서 나와요. 낙관적인 FeatGEO의 설계 최적화와 이 회의적 벤치마크를 함께 읽으면, "무엇을 담을지"만큼 "어떻게 검색에 신뢰받을지"가 GEO의 절반이라는 게 또렷해져요.
자주 묻는 질문
대화형 SEO(C-SEO)가 정말 효과가 있나요?
대부분은 효과가 없고, 일부 도메인에서는 오히려 인용 순위를 떨어뜨렸어요. 6개 도메인 × 10개 기법 조합에서 통계적으로 유의한 양의 이득은 단 3건뿐이었고, 그것도 제품 추천(Retail·Video Games) 도메인에 한정됐어요. 권위·통계·인용 삽입 같은 고전적 본문 재작성은 평균 이득이 0 근방이거나 음수였어요.
그럼 무엇이 실제로 통하나요?
문서를 LLM 컨텍스트의 앞자리에 올리는 전통 SEO, 즉 검색·리트리벌 랭킹 자체를 올리는 것이 압도적이었어요. Retail에서 앞자리(Position 1) 배치는 +2.77의 순위 이득을 줬는데, 최고 C-SEO 기법(+0.36)보다 약 7.7배 컸어요. 레버는 본문 수사보다 검색 가시성이에요.
효과 있는 소수 기법은 계속 통하나요?
아니에요. 모두가 같은 기법을 채택하면 이득이 0으로 수렴하는 제로섬 구조였어요. LLM Guidance는 채택률 10%에서 약 +0.36이던 이득이 100%에서 약 +0.04로 거의 사라졌어요. 얼리어답터 프리미엄만 있고 지속 우위는 아니에요.
엔진을 바꿔도 같은 결과인가요?
아니에요. GPT-4o-mini에서 통했던 소수 기법이 Claude-3.5-Haiku에서는 단 하나도 유의하지 않았고, 제품 추천 30개 케이스 중 26개가 유의하게 순위를 떨어뜨렸어요. 단일 엔진에 맞춘 C-SEO 처방은 일반화되지 않아요.
참고자료
요약
- C-SEO Bench는 대화형 검색 SEO를 2개 태스크·6개 도메인·약 1.9k 쿼리에서, 그리고 채택률 0–100%를 바꿔 가며 처음으로 멀티-액터로 검증한 벤치마크예요.
- 권위·통계·인용 같은 본문 재작성형 C-SEO는 대부분 무효였고, 6×10 조합 중 유의한 양의 이득은 3건뿐이었어요. 일부 도메인에선 순위를 떨어뜨리기까지 했어요.
- 실제로 통하는 건 문서를 컨텍스트 앞자리에 올리는 전통 SEO였어요. Position 1은 +2.77로 최고 C-SEO(+0.36)의 약 7.7배였어요.
- 효과 있는 소수 기법도 모두가 채택하면 이득이 0으로 수렴하는 제로섬이라, 선점 타이밍 자산일 뿐 지속 우위는 아니에요.
- GPT-4o-mini에서의 성공조차 Claude-3.5-Haiku에선 재현되지 않아, 단일 엔진 over-fit은 위험하다는 게 교훈이에요.
이 글처럼 AI가 답할 키워드 전략을 자동으로 세워보세요
TRAIL Search가 브랜드가 AI 검색에 어떻게 노출되는지 진단하고, 어떤 콘텐츠를 써야 인용되는지 처방해요.
AI 검색 가시성 진단하기